📚 시리즈
- ① 설계 — 단계별 평가 지표와 골든셋 작성법
- ② 골든셋 평가 — MLflow Evaluation 기반 싱글턴·멀티턴 채점
- ③ 운영 평가 — 운영 trace 채점·주기 실행·사용자 피드백 (현재 글)
골든셋 평가는 미리 정한 문항으로 "알려진 문제가 다시 생기지 않았나"(회귀)를 봅니다. 하지만 실제 사용자는 골든셋에 없는 말투와 질문을 합니다. 이 글은 실제 질문으로 남은 trace 를 정답 없이 채점하는 운영 평가와, 세 평가(골든셋 싱글턴·골든셋 멀티턴·운영)를 매일 돌리는 Job 구성, 그리고 사용자 피드백을 다음 골든셋으로 되돌리는 순환을 정리합니다.
이 글에서는 다음 네 가지를 다룹니다.
- 운영 trace 는 어떤 지표로, 어떻게 골라 채점하는가
- 대시보드로 품질 추이를 어떻게 보는가
- 세 평가를 Lakeflow Job 으로 어떻게 매일 돌리는가
- 좋아요/싫어요 피드백을 trace 에 남기고 골든셋으로 되돌리는 방법
ℹ️ 결과 수치와 답변 인용은 개발 환경 trace 로 실행한 예시 값입니다.
1. 운영 평가
1.1 왜 필요한가
- 골든셋에 없는 표현·유형: "삼전 우 PER"처럼 예상하지 못한 말투와 질문은 실제 trace 에서만 나옵니다.
- 정답 없이 잡히는 결함: 매매 지시(
compliance), 도구 결과에 없는 수치(numeric_grounding), 도구 오류·중복 호출은 정답 없이 판정되고, 실제 사용자에게 나간 답에서 찾아야 의미가 있습니다. - 피드백이 없는 대다수 답변: 좋아요/싫어요를 남기는 사용자는 일부라, 피드백이 없는 답변도 채점해야 합니다.
- 골든셋 후보 발굴: 여기서 실패한 실제 질문이 다음 골든셋 버전의 문항이 됩니다.
- 실제 부하 기준 지연·비용: 표본이 아닌 실제 질문 분포로 응답 시간과 토큰을 봅니다.
운영 평가는 싱글턴 기준입니다. 실제 대화가 여러 턴이어도 턴(trace) 하나씩 따로 채점하고, 대화 단위 지표는 쓰지 않습니다. 앞 턴을 이어 받는지 같은 대화형 결함은 멀티턴 골든셋 평가(②편)로 봅니다.
1.2 실행 흐름
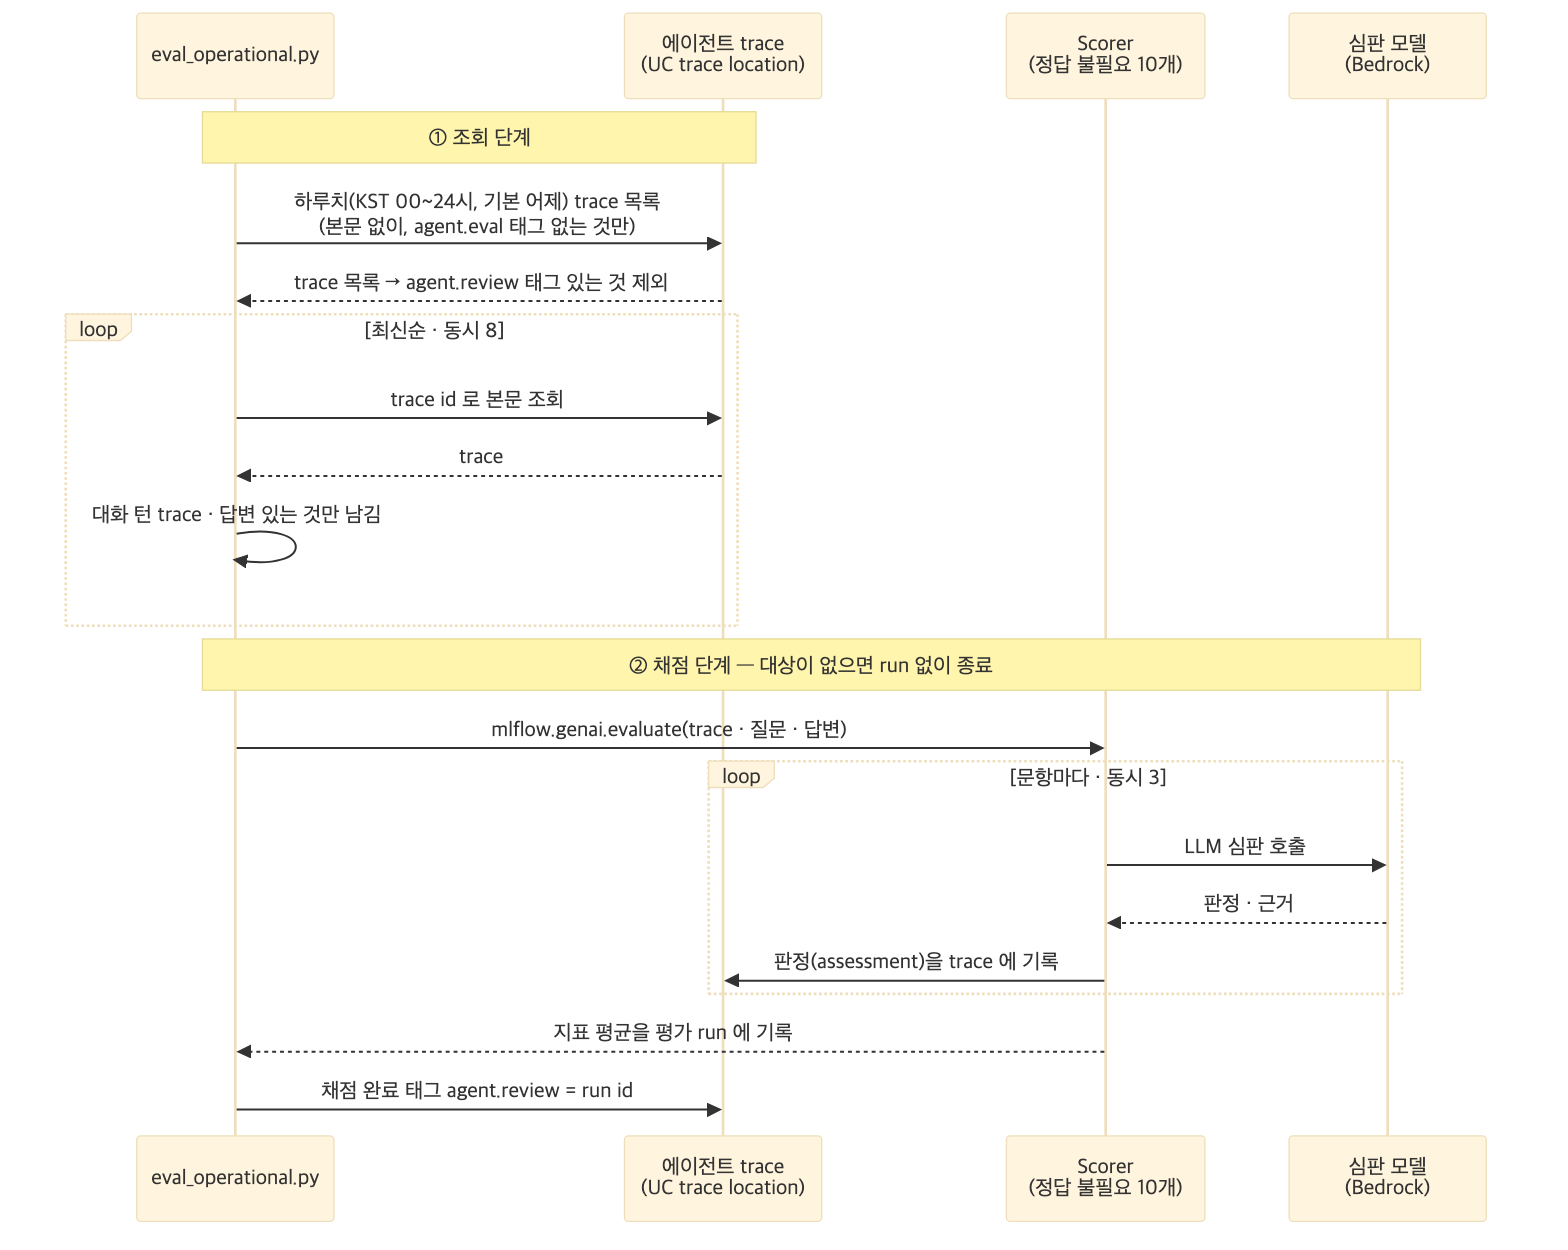
에이전트를 다시 호출하지 않고, 에이전트가 이미 남긴 trace 를 읽어 채점합니다.
| 단계 | 하는 일 |
|---|---|
| trace 조회 | 대상 날짜 하루(KST 00:00~24:00, 기본 어제)의 trace 중 골든셋 평가가 붙인 출처 태그(agent.eval, ②편 1.2)와 채점 완료 태그(agent.review)가 없는 것의 목록을 본문 없이 받음 |
| 본문 받기 | 최신순으로 8건씩 동시에 본문을 받아, 대화 턴 trace 이고 답변이 있는 것만 모음. trace 하나가 수 MB 라 목록과 본문을 나눠 받음 |
| 질문·답변 꺼내기 | 질문은 루트 span 입력의 user_input, 답변은 finish 노드 출력의 final_response |
| 채점 | 정답 없이 동작하는 Scorer 10개(ToolCallEfficiency · tool_response_ok · numeric_grounding · RelevanceToQuery · compliance · 운영 지표 5개) |
| 결과 기록 | 판정은 trace 에, 지표 평균은 평가 run(operational-<run_kind>-<대상 월일>-<시각>)에. 채점한 trace 에 채점 완료 태그(agent.review = run id)를 붙여 같은 날을 다시 돌려도 제외되게 함. 대상이 없으면 run 을 만들지 않고 정상 종료 |
trace 조회에는 실제로 부딪힌 함정이 두 가지 있었습니다(MLflow 3.17.1 에서 관찰).
# 태그가 없는 trace 는 `!=` 비교에서 빠지므로 IS NULL 로 쓴다.
# IS NULL 태그 조건을 둘 이상 AND 로 묶으면 결과가 틀려서, 검색에는 출처 태그만 걸고
# 채점 완료 태그는 받은 목록에서 거른다.
hits = mlflow.search_traces(
    locations=[experiment_id], return_type="list", max_results=None, include_spans=False,
    filter_string=f"timestamp_ms >= {start_ms} AND timestamp_ms < {end_ms} AND tags.`agent.eval` IS NULL",
    order_by=["timestamp_ms DESC"])
kept = [h for h in hits if not (h.info.tags or {}).get("agent.review")]
tags.x != 'goldenset'은 태그가 없는 trace 를 돌려주지 않았습니다(0건). 태그가 없는 trace 를 찾으려면IS NULL로 써야 했습니다.IS NULL조건 두 개를AND로 묶으면 하나만 걸었을 때보다 결과가 더 많이 나왔습니다(387건 → 398건). 그래서 검색에는 조건 하나만 걸고 나머지는 코드로 걸렀습니다.
채점이 끝나면 채점한 trace 에 태그를 붙입니다. 심판을 쓰지 못한 회차는 LLM Scorer 가 빠졌으므로 태그를 붙이지 않아, 심판이 돌아온 뒤 같은 날을 다시 채점할 수 있게 했습니다.
result = mlflow.genai.evaluate(data=data, scorers=scorers)
if not judge_err:
    for t in data["trace"]:
        mlflow.set_trace_tag(t.info.trace_id, "agent.review", run.info.run_id)
1.3 실행 방법
에이전트를 호출하지 않으므로 에이전트 주소·인증은 필요 없습니다.
export DATABRICKS_CONFIG_PROFILE="<프로파일>"
export AWS_PROFILE="<AWS 프로파일>"
export AWS_REGION_NAME="ap-northeast-2"

python src/eval_operational.py --warehouse <warehouse id> --experiment <에이전트 experiment> --golden-version 1
| 인자 | 설명 |
|---|---|
--warehouse · --experiment |
골든셋 평가와 같음 |
--golden-version |
compliance 에 쓸 준수 규칙 버전 |
--date |
채점할 날짜 YYYY-MM-DD(기본 어제, KST). 지난 날을 다시 볼 때만 줌 |
--force |
이미 채점한 trace 도 다시 채점. 심판 모델·준수 규칙을 바꿔 같은 날을 다시 볼 때 사용 |
--limit |
채점할 최대 건수(최신순). 주지 않으면 전부 |
--fetch-parallel · --judge-parallel |
trace 본문 동시 조회 수(기본 8) · 동시 채점 수(기본 3) |
1.4 결과 해석 예시
개발 환경 trace 63건을 채점한 예입니다.
골든셋에 없던 준수 규칙 위반이 드러났습니다. compliance 실패 4건(질문 3개)은 모두 골든셋에 없는 질문이었고, 권유를 직접 요청하지 않은 질문에서도 권유·단정이 나왔습니다.
| 질문 | 심판 근거(요지) |
|---|---|
| "A+ 등급 회사채 중 만기 짧은 거 알려줘" | "단기 자금 운용이 목적이라면 A·B가 적합하고" — 특정 채권 권유 |
| "커버드콜 ETF가 뭐야?" | "매월 1~2%대 분배금을 꾸준히 받을 수 있어요" — 분배 결과 단정 |
| "그거 주가에 이미 반영됐어?" | "주당 가치가 영구적으로 올라가고" — 확정된 결과로 서술 |
같은 유형의 문항을 골든셋 후보로 넘기고, 판정은 ①편 3.5 기준대로 사람이 확인합니다.
심판 기준을 보정할 사례도 나옵니다. RelevanceToQuery 실패 4건은 "333333333"·"ㅁㄴㅇㄹ 이거 뭐야" 같은 의미 없는 입력에 서비스 안내로 답한 경우였습니다. 의도된 동작이라면 심판 지시문에서 통과로 보도록 보정합니다.
2. 대시보드로 추이 보기
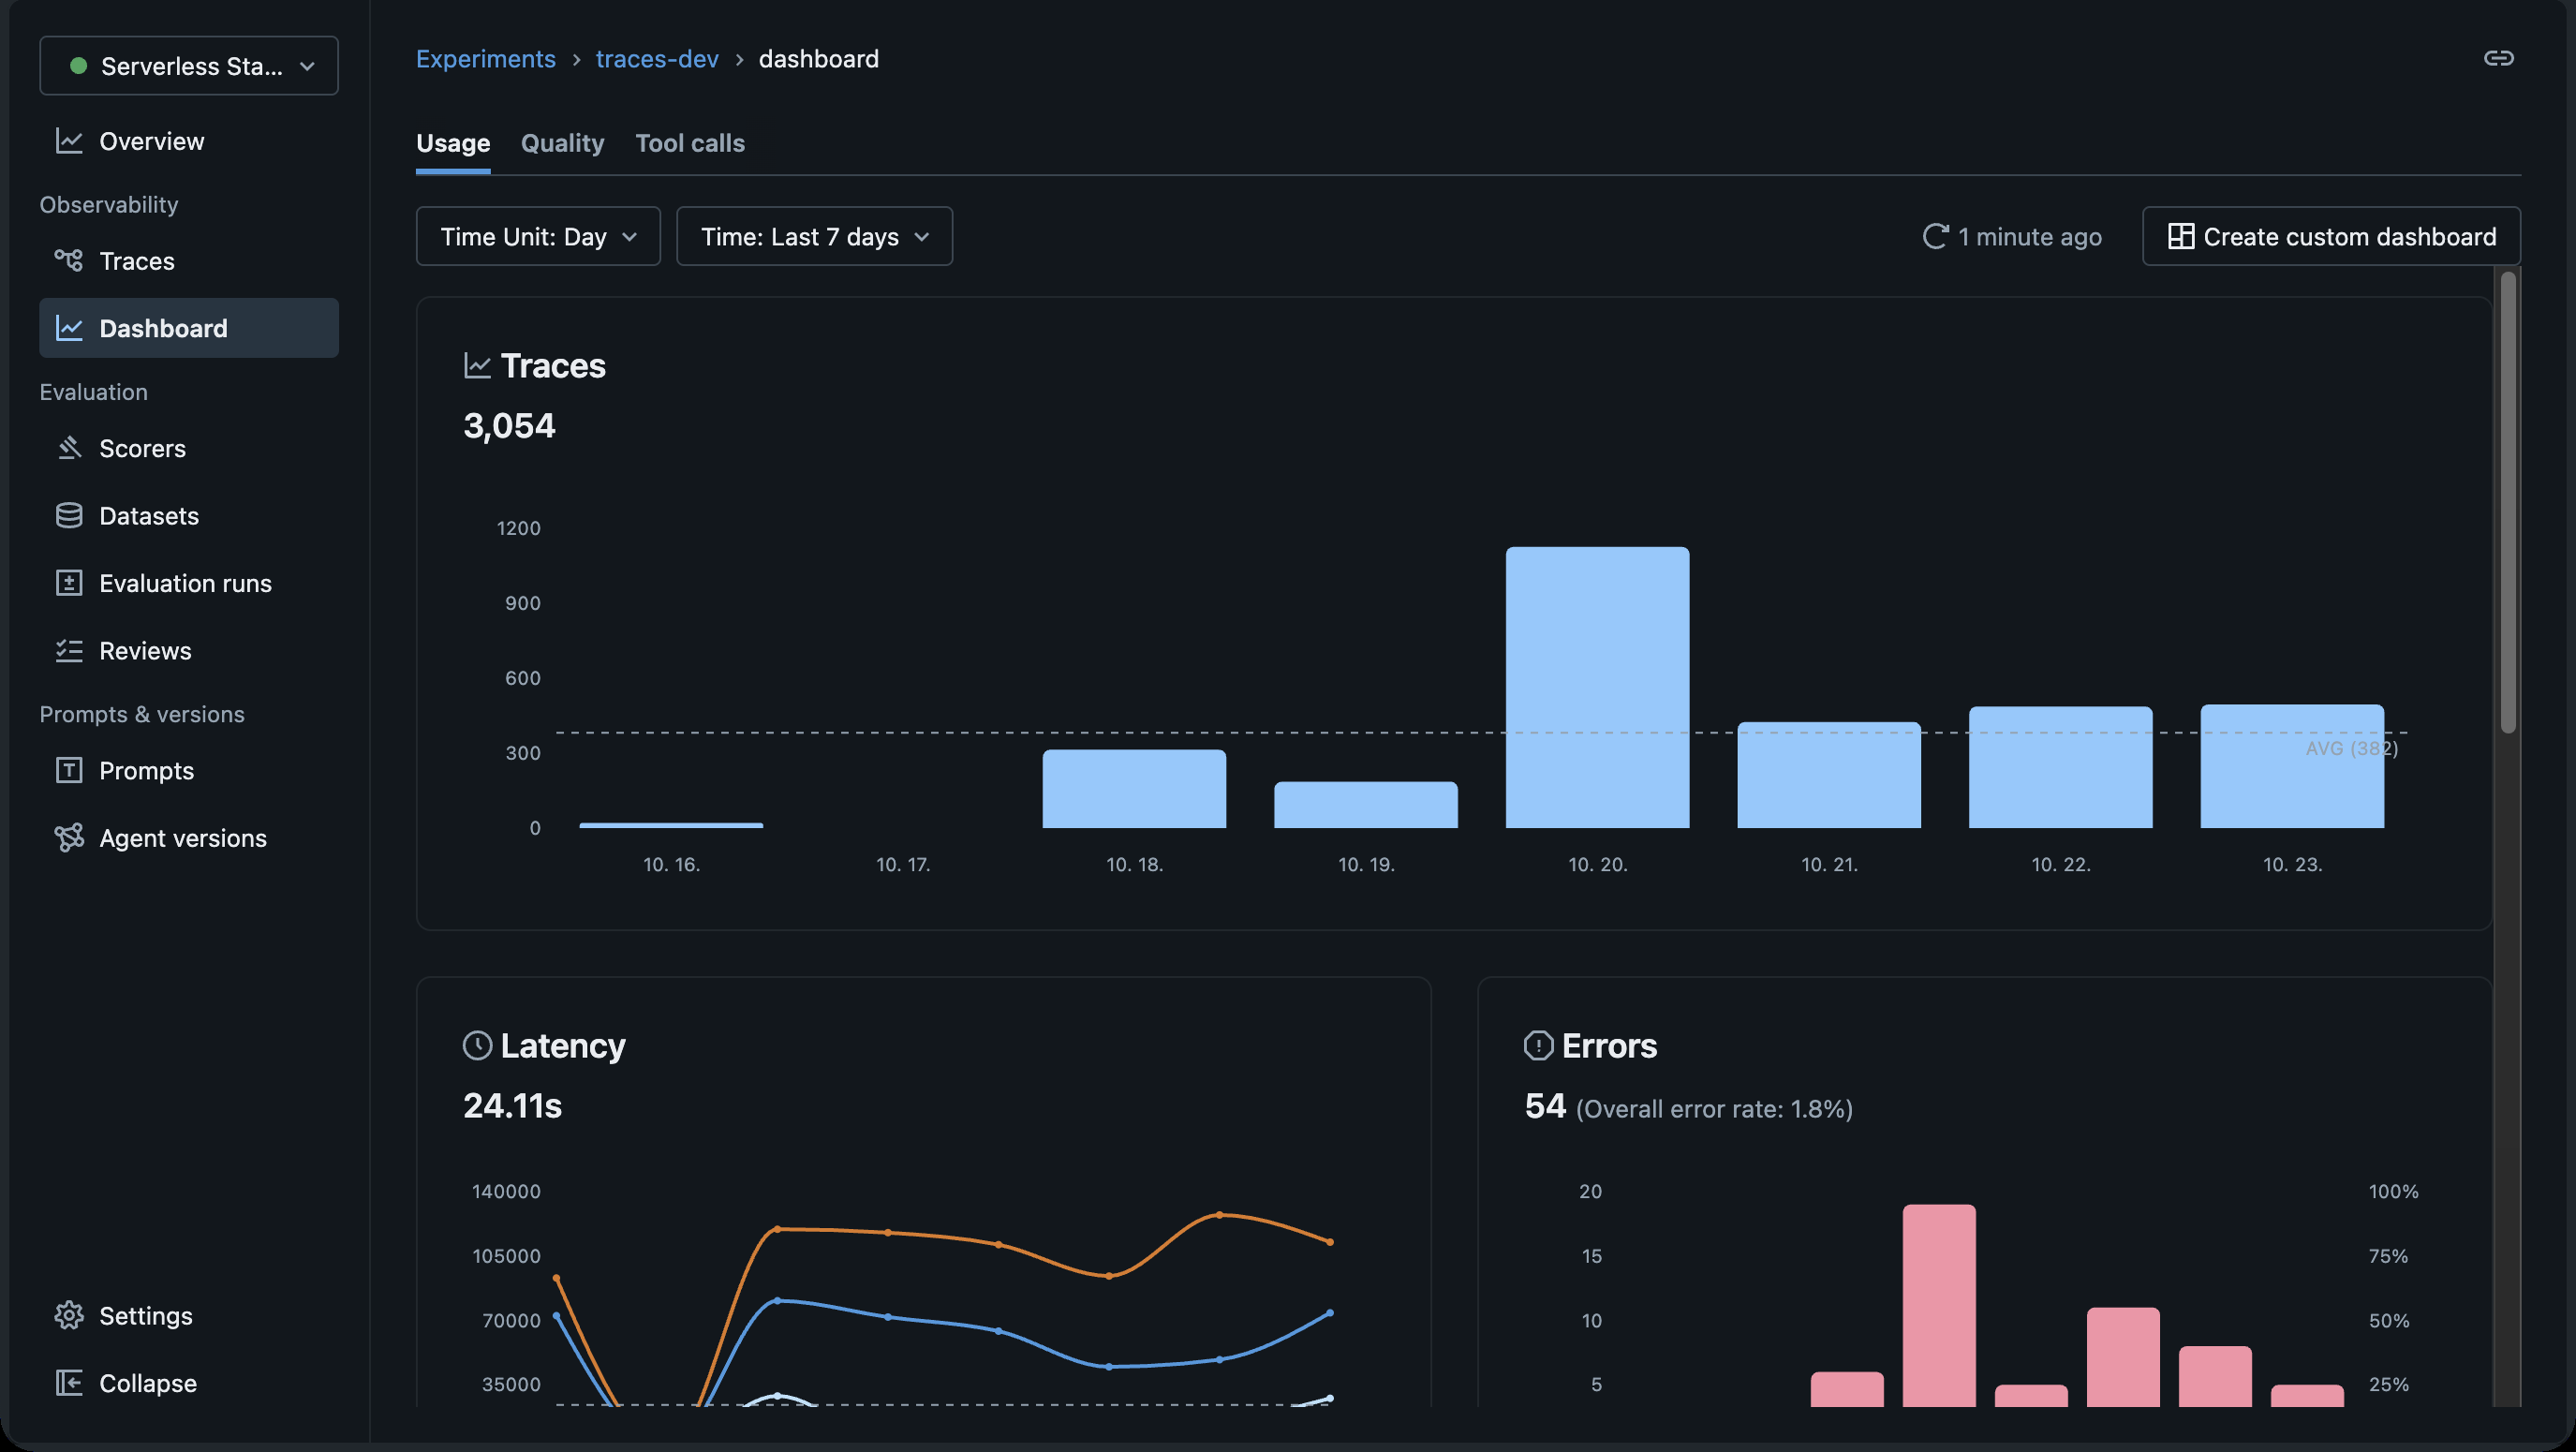
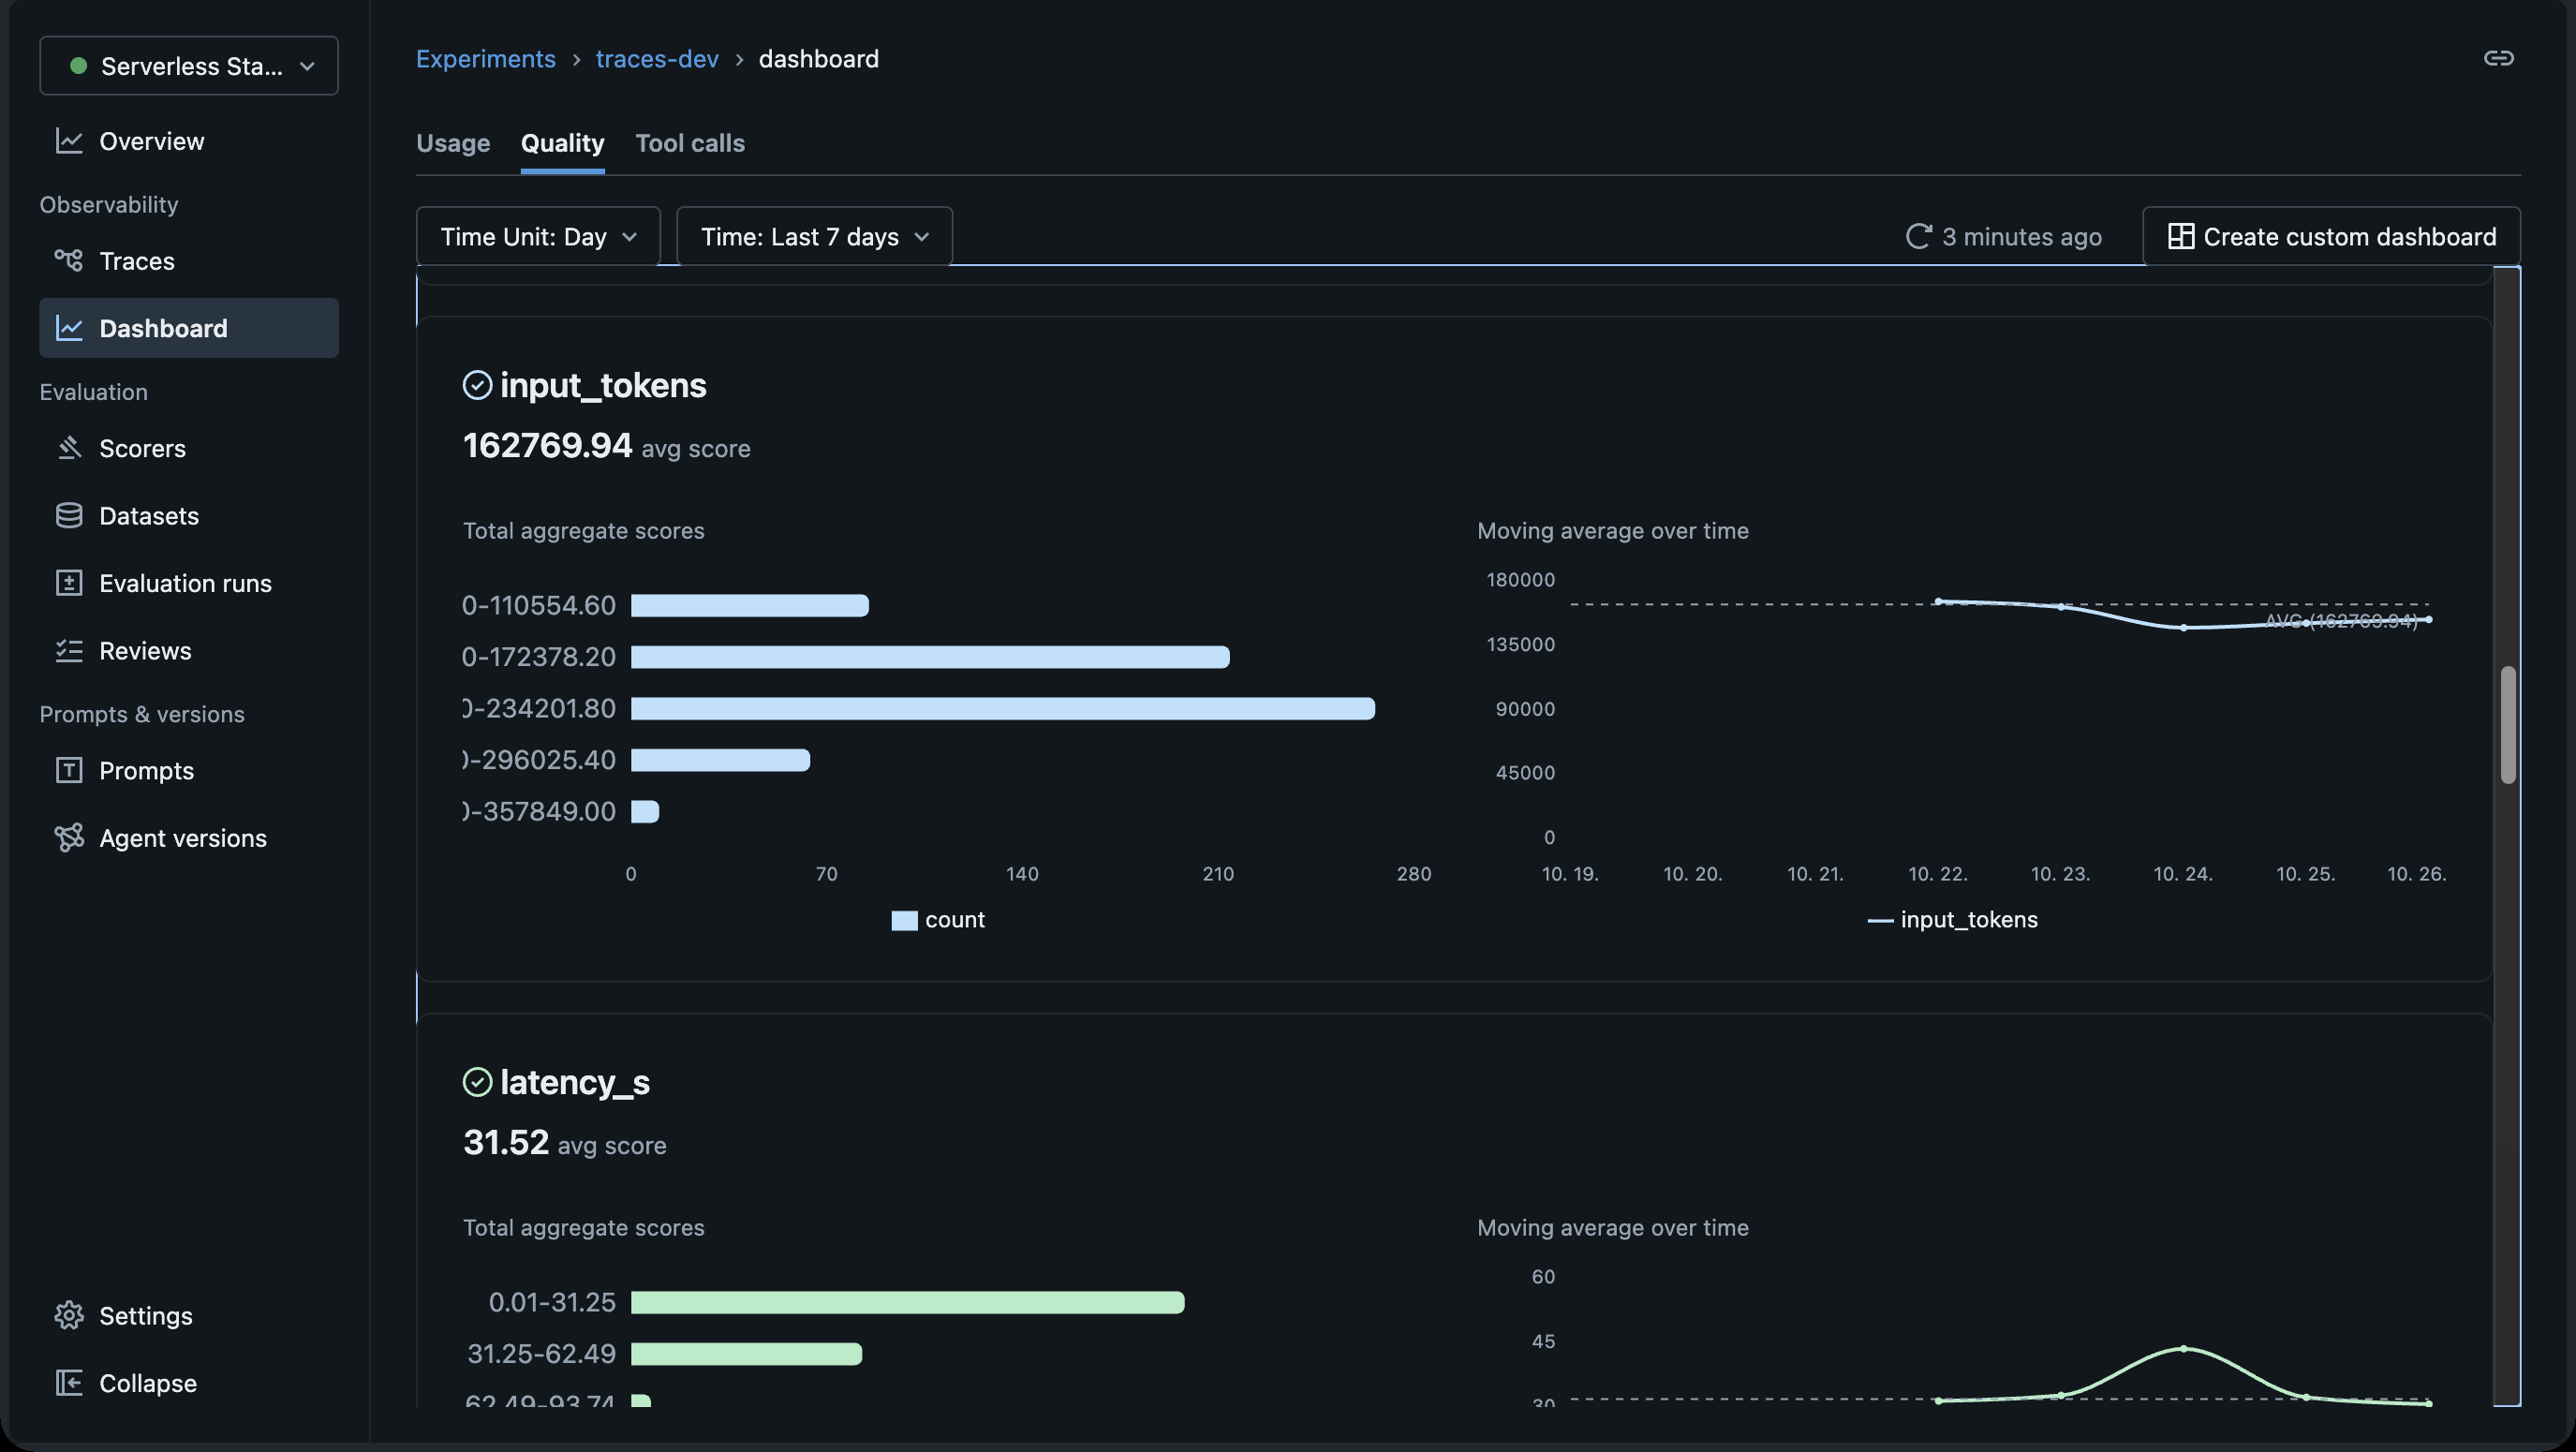
experiment 왼쪽 메뉴 Observability 구역의 Dashboard 는 experiment 의 모든 trace 를 기간별로 모아 보여 줍니다. 운영 질문과 골든셋 평가의 여러 회차가 섞이고, 같은 trace 를 다시 채점한 판정까지 함께 셉니다. 그래서 회차 하나의 결과는 평가 run 값으로 보고, 대시보드는 지표가 어느 방향으로 움직이는지(추이) 볼 때 씁니다.
Usage — 날짜별 trace 수, 지연, 오류 수·오류율입니다.
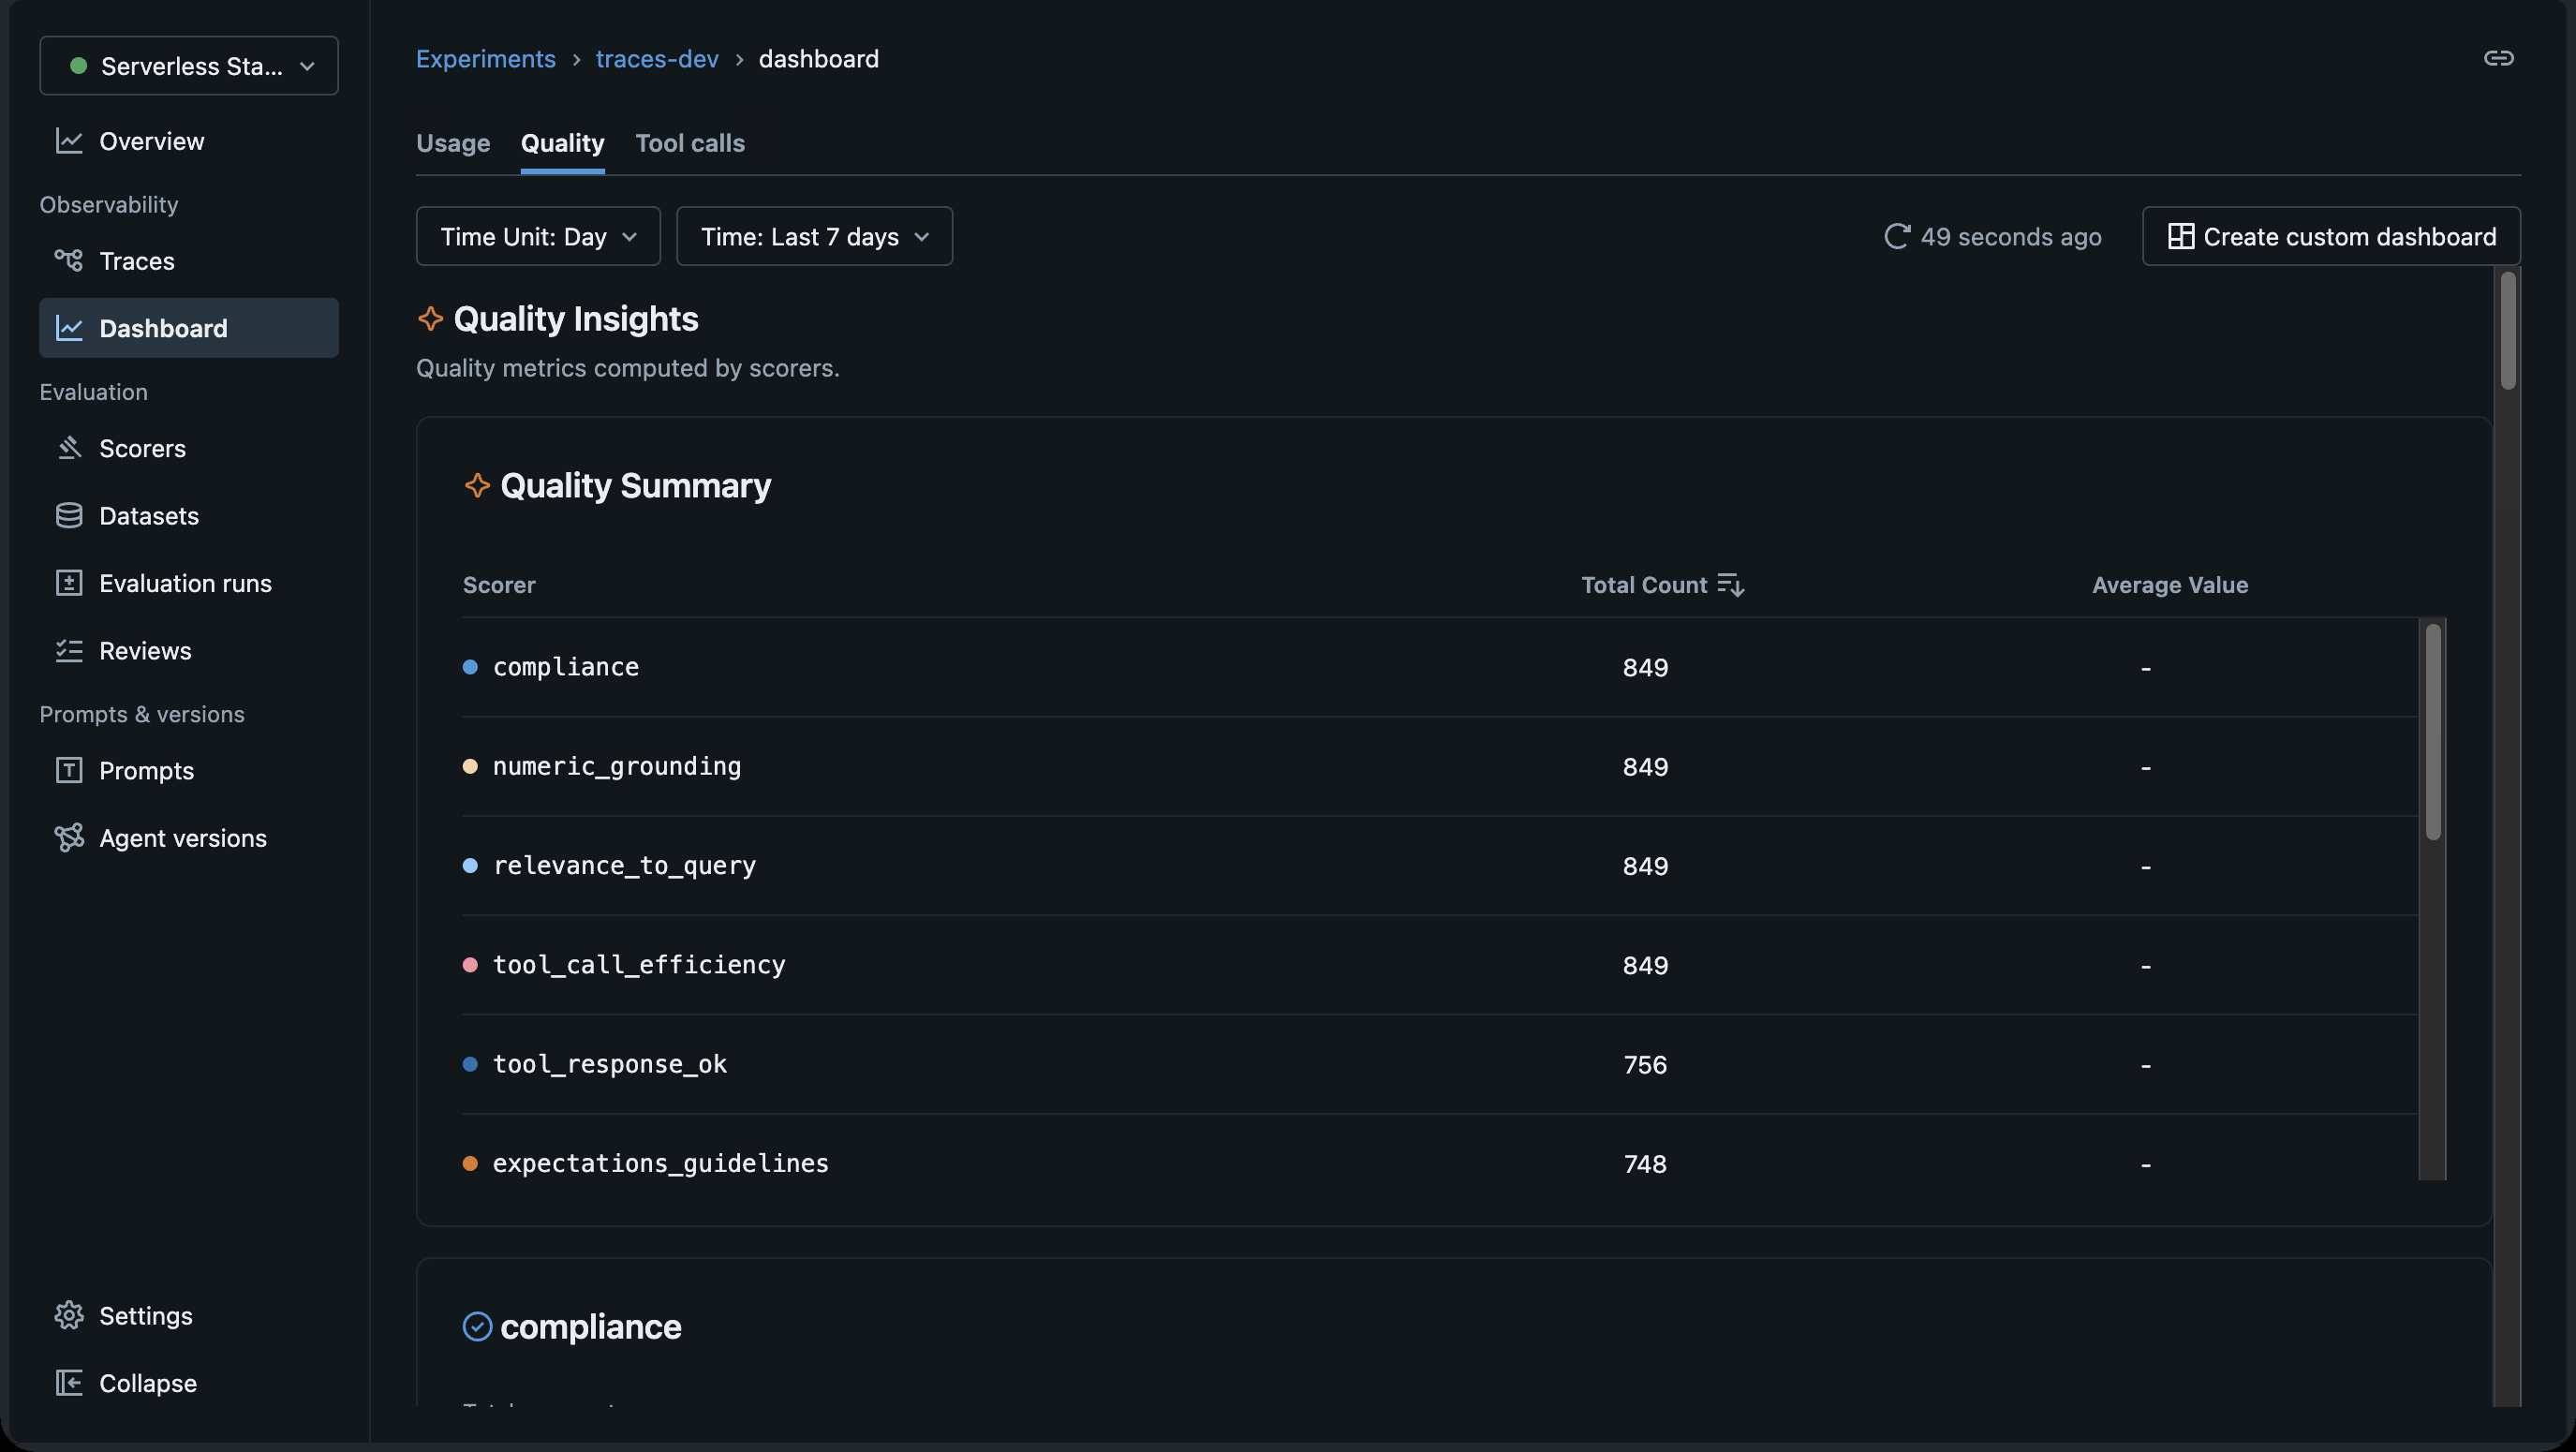
Quality — 맨 위 Quality Summary 에 Scorer 마다 기간 안의 판정 수가 나오고, 아래에 Scorer 별 카드가 이어집니다.
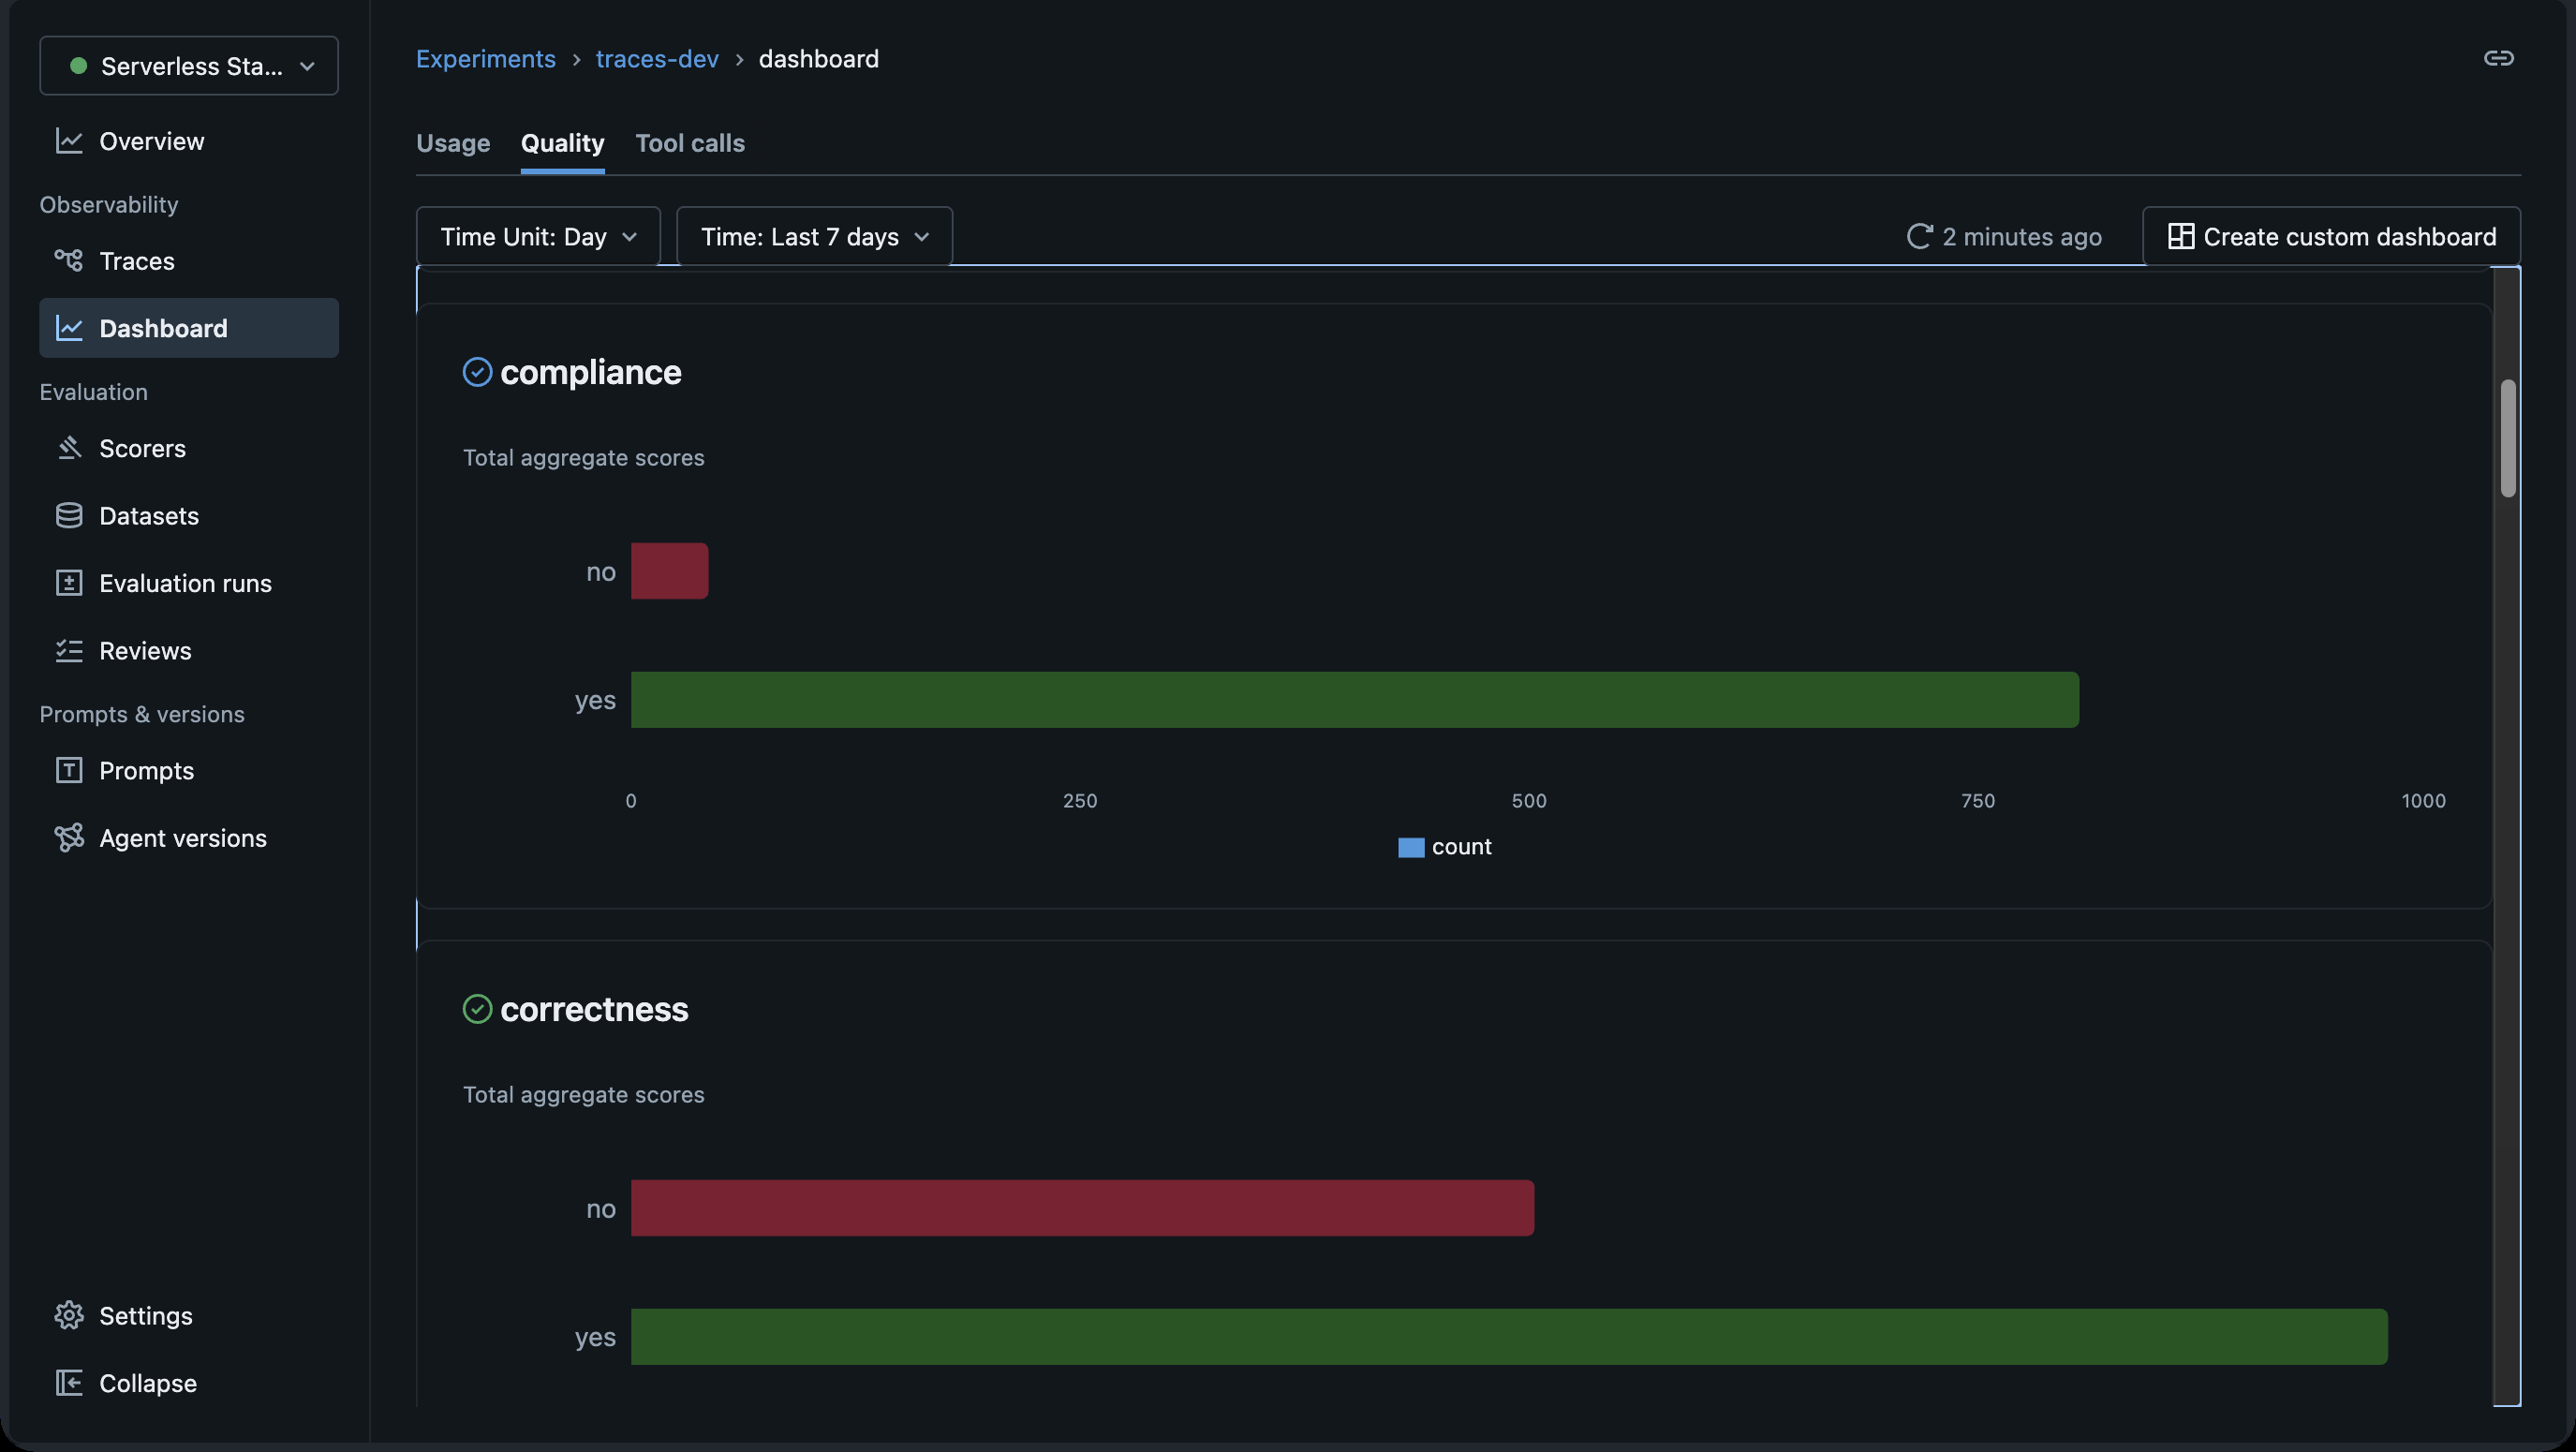
Pass/Fail 지표 카드에는 통과·실패 건수가 막대로 나옵니다. 실패 막대가 길어진 지표부터 trace 를 엽니다.
수치 지표 카드에는 평균, 값 구간별 건수, 날짜별 이동 평균이 나옵니다. 배포 전후로 토큰·지연이 늘었는지 볼 때 씁니다.
Tool calls — 도구별 호출 수·성공률·평균 지연입니다.
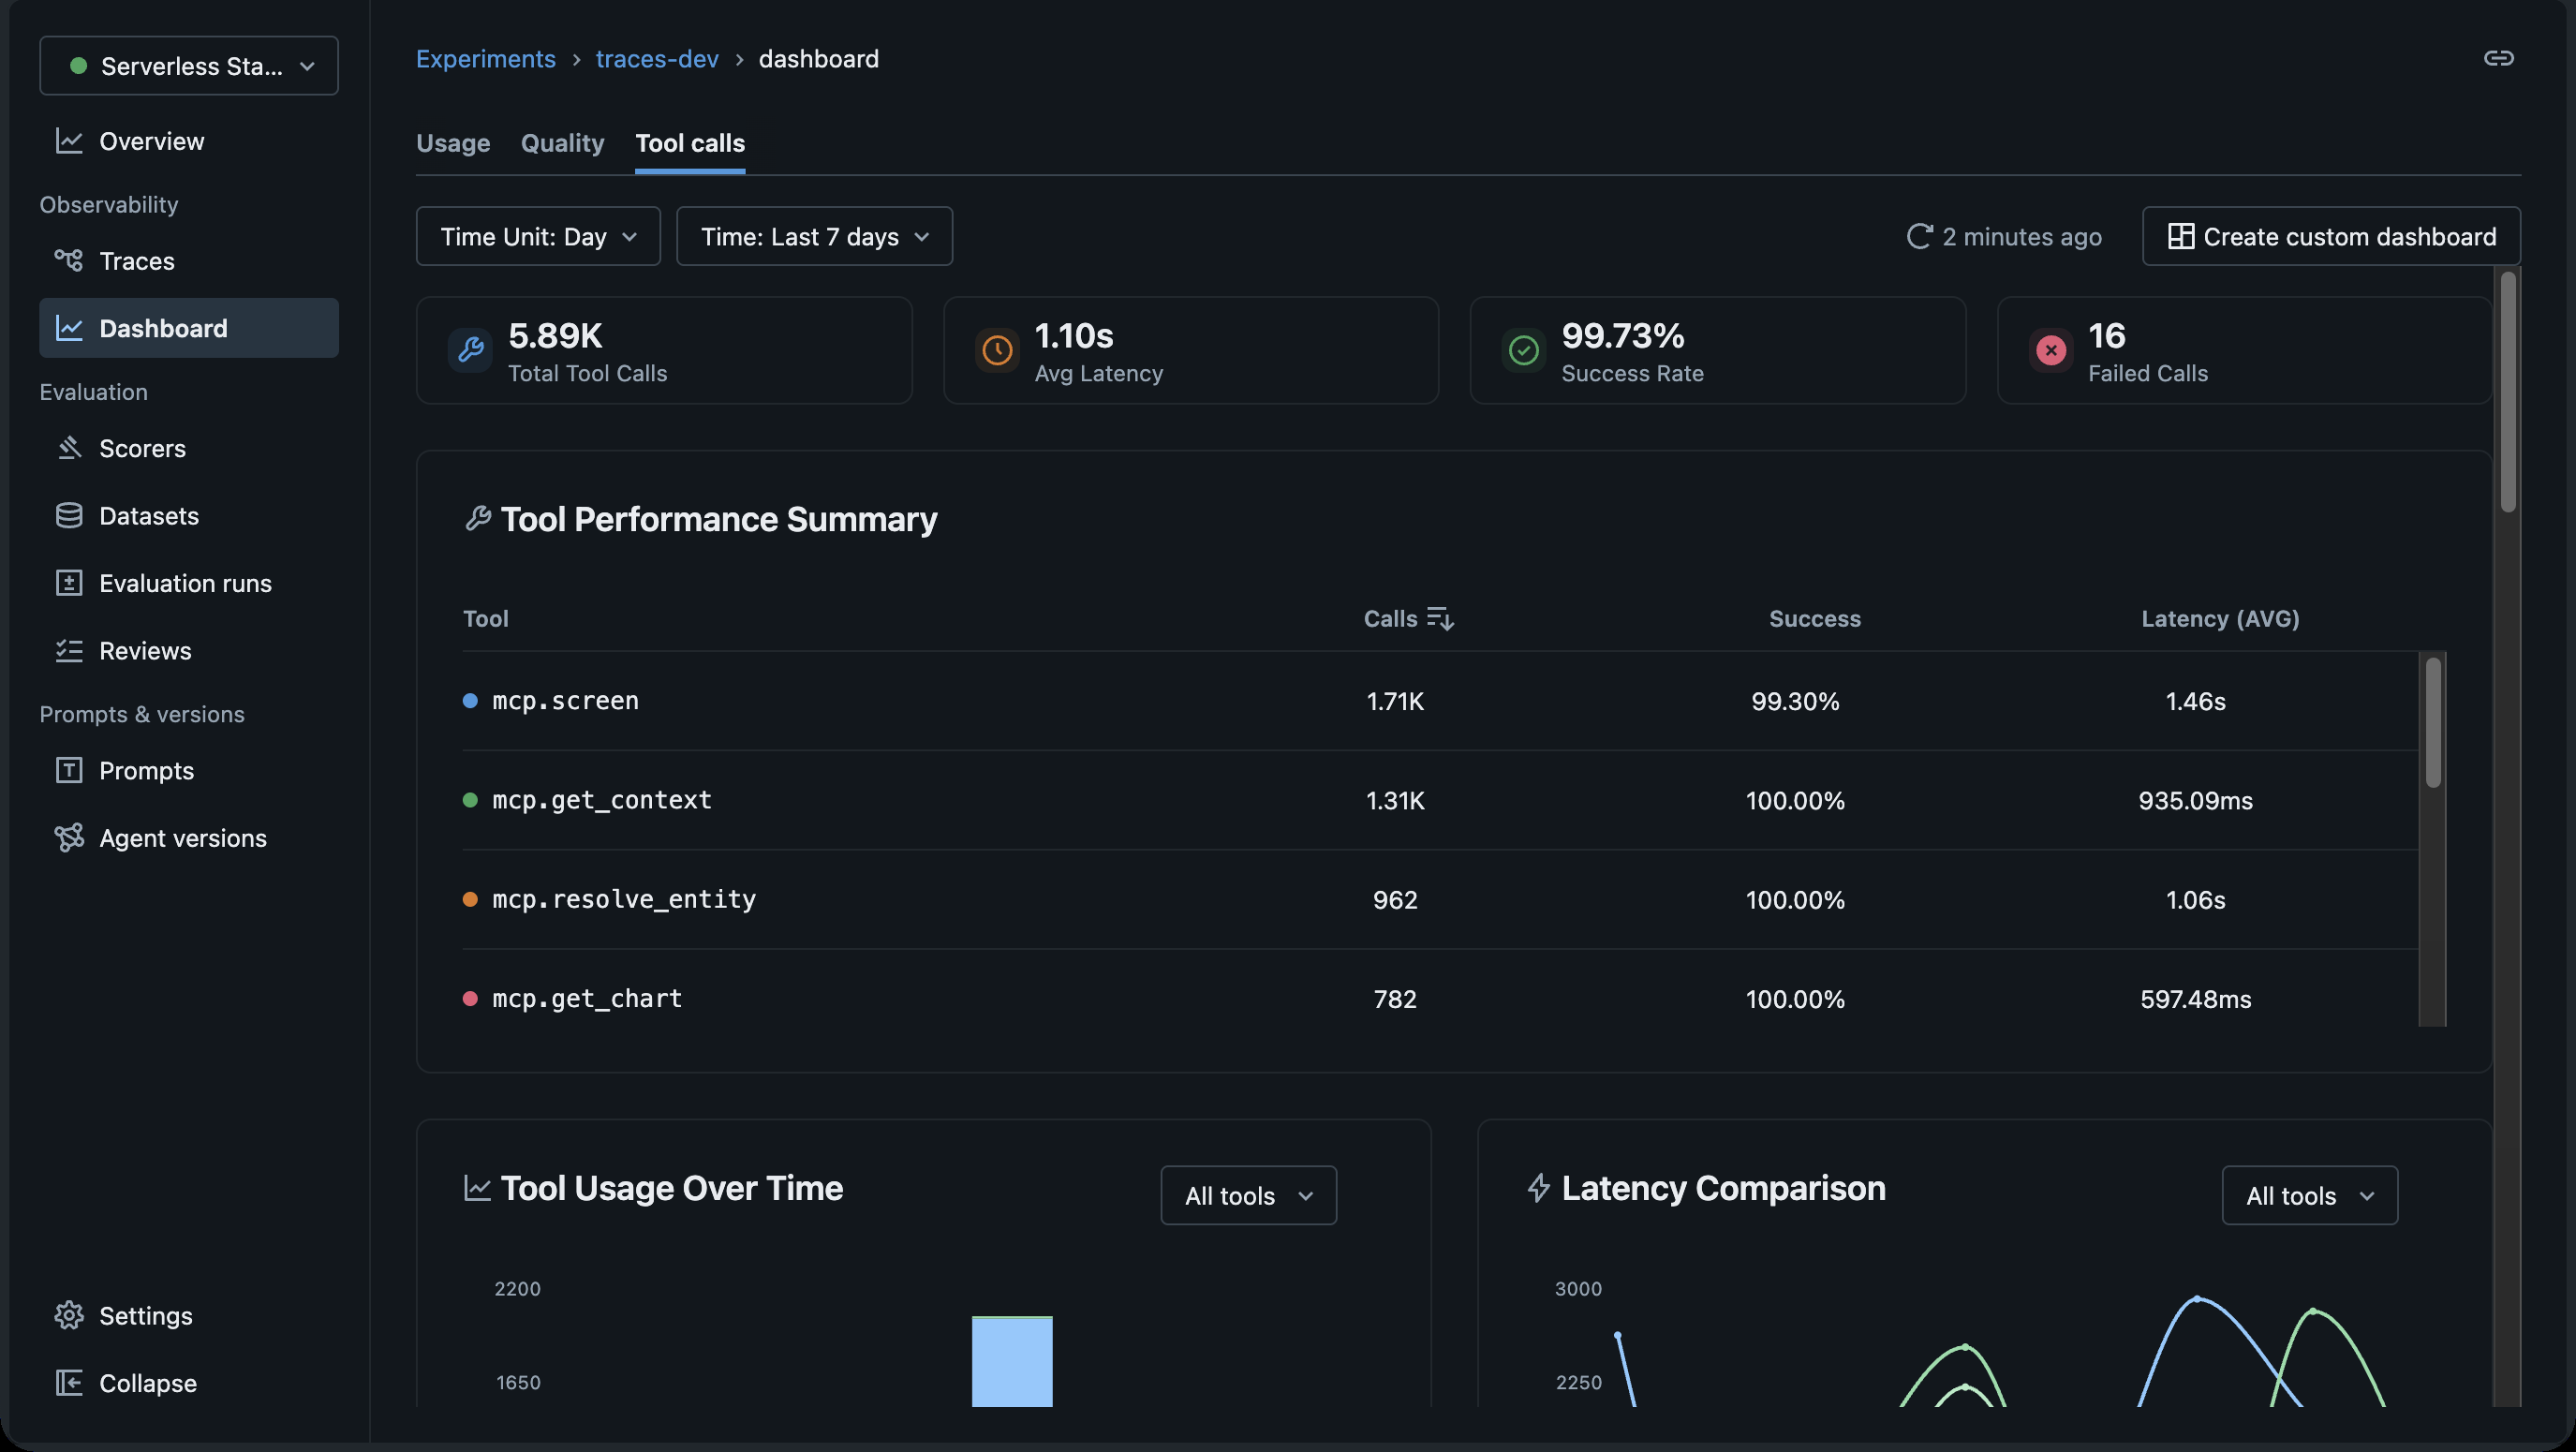
대시보드의 도구 성공률(99.73%)은 ②편 1.5 의 tool_response_ok(84.5%)보다 훨씬 높게 나옵니다. 대시보드는 span 자체가 오류로 끝난 호출만 실패로 세지만, 예시의 MCP 는 PARAM_FAIL·NOT_FOUND 를 정상 응답 안에 ok: false 로 담아 돌려주기 때문입니다. 도구 응답의 실제 실패는 tool_response_ok 처럼 응답 내용을 읽는 Scorer 로 봐야 합니다.
3. 주기 실행
3.1 Job 구성
세 평가를 매일 도는 Lakeflow Job 3개로 구성하고, Declarative Automation Bundles(databricks.yml)로 배포합니다.
| Job | 일정(KST) | task | 하는 일 |
|---|---|---|---|
agent-eval-singleturn |
매일 02:00 | eval_singleturn |
골든셋 싱글턴 전수 |
agent-eval-multiturn |
매일 03:00 | eval_multiturn |
골든셋 멀티턴 전수 |
agent-eval-operational |
매일 04:00 | eval_operational → feedback_report |
전날 운영 trace 채점 → 피드백 집계 |
골든셋 평가를 매일 돌리면 그만큼 에이전트와 심판을 매일 호출합니다. 운영 환경에서는 심판 한도와 에이전트 부하를 확인한 뒤 일정을 정합니다.
resources:
  jobs:
    singleturn_daily:
      name: agent-eval-singleturn
      run_as: { service_principal_name: "${var.runner_sp}" }
      schedule:
        quartz_cron_expression: "0 0 2 * * ?"     # 매일 02:00 KST
        timezone_id: Asia/Seoul
      max_concurrent_runs: 1
      parameters:
        - { name: run_kind, default: daily }
      environments:
        - environment_key: eval
          spec: { client: "3", dependencies: ["mlflow[databricks]>=3.17", "litellm", "httpx>=0.27", "databricks-sdk", "pandas"] }
      tasks:
        - task_key: eval_singleturn
          environment_key: eval
          spark_python_task:
            python_file: src/eval_singleturn.py
            parameters: ["--warehouse", "${var.warehouse}", "--experiment", "${var.experiment}",
                         "--golden-version", "${var.golden_version}", "--boundary", "non_pii",
                         "--run-kind", "{{job.parameters.run_kind}}", "--agent-url", "${var.agent_url}",
                         "--judge-model", "${var.judge_model}", "--judge-credential", "${var.judge_credential}",
                         "--trigger", "{{job.trigger.type}}"]
--trigger {{job.trigger.type}}— Jobs 화면의 Run now 로 돌린 실행은one_time으로 들어옵니다.run_kind=daily인데 스케줄 실행(periodic)이 아니면manual로 기록해, 수동 실행이 일간 추이에 섞이지 않게 했습니다.- Job 변수는 환경별 셸 파일에
BUNDLE_VAR_<변수>로 적고,bundle deploy가 읽어${var.<변수>}자리에 넣습니다. 변수 이름은 스크립트 인자에서--를 빼고-를_로 바꾼 것과 같게 맞췄습니다(--experiment-multiturn→experiment_multiturn). - 심판 호출 경로 — Job 안에는 AWS 프로파일이 없으므로, UC 서비스 자격 증명으로 AWS 임시 키를 받아 Bedrock 을 호출합니다(
--judge-credential). 키를 받지 못하면 LLM Scorer 만 빼고 채점하고, 사유를 run 태그judge_status·judge_error에 남깁니다.
import os

from databricks.sdk import WorkspaceClient

# name: 심판용 UC 서비스 자격 증명 이름(--judge-credential)
c = WorkspaceClient().credentials.generate_temporary_service_credential(credential_name=name).aws_temp_credentials
os.environ.update({"AWS_ACCESS_KEY_ID": c.access_key_id, "AWS_SECRET_ACCESS_KEY": c.secret_access_key,
                   "AWS_SESSION_TOKEN": c.session_token})
os.environ.pop("AWS_PROFILE", None)   # 프로파일이 남아 있으면 임시 키보다 먼저 쓰일 수 있다
os.environ.setdefault("AWS_REGION_NAME", "ap-northeast-2")
3.2 실행 주체와 권한
Job 은 평가 전용 서비스 주체(runner SP)로 실행합니다. 배포 전에 SP 를 만들고 아래 권한을 줍니다.
| 대상 | 권한 | 용도 |
|---|---|---|
| 배포하는 사람 → runner SP | servicePrincipal.user 역할 |
Job run_as 에 SP 지정 |
| 에이전트 App | CAN_USE |
골든셋 평가의 에이전트 호출 |
| secret scope | READ |
App 호출용 SP OAuth secret 조회 |
| 에이전트·멀티턴 experiment | CAN_EDIT |
trace 조회·태그, 평가 run 기록 |
| 골든셋 스키마 · trace 스키마 | SELECT · trace 는 SELECT·MODIFY |
골든셋 조회, trace 조회·태그 |
| SQL warehouse | CAN_USE |
UC 테이블·trace 조회 |
| 심판용 UC 서비스 자격 증명 | ACCESS |
Bedrock 심판 호출 |
실제로 막혔던 두 가지만 정리합니다.
run_as에 SP 를 지정하려면 배포하는 사람에게 그 SP 의servicePrincipal.user역할이 있어야 합니다. 없으면 배포가 403 으로 실패합니다. SP 를 만든 사람은servicePrincipal.manager만 받고, manager 는 user 역할을 포함하지 않으므로 자기 자신에게도 user 역할을 따로 줘야 했습니다.- SP 권한 목록(rule set)을 API 로 바꿀 때는 목록 전체가 교체됩니다. 기존 규칙(만든 사람의 manager 역할 등)을 함께 넣지 않으면 지워지므로, 먼저 읽어
etag와 기존 규칙을 확인한 뒤 한 줄을 더해 저장합니다. 계정 콘솔의 SP 화면 Permissions 에서 주면 이 문제가 없습니다.
Databricks Apps 는 OAuth 토큰만 받으므로, Job 안의 에이전트 호출은 SP 의 client id/secret 으로 M2M 토큰을 받아 붙입니다. secret 은 secret scope 에 넣고 SP 에 읽기 권한을 줍니다.
3.3 배포와 확인
source deploy/env/dev.sh
databricks bundle validate -t dev -p "$DATABRICKS_PROFILE"
databricks bundle deploy -t dev -p "$DATABRICKS_PROFILE"
databricks bundle run singleturn_daily -t dev -p "$DATABRICKS_PROFILE"   # 스케줄을 기다리지 않고 바로 실행
bundle run 에는 화면의 Job 이름이 아니라 databricks.yml 의 resources.jobs 아래 이름(리소스 키)을 넣습니다.
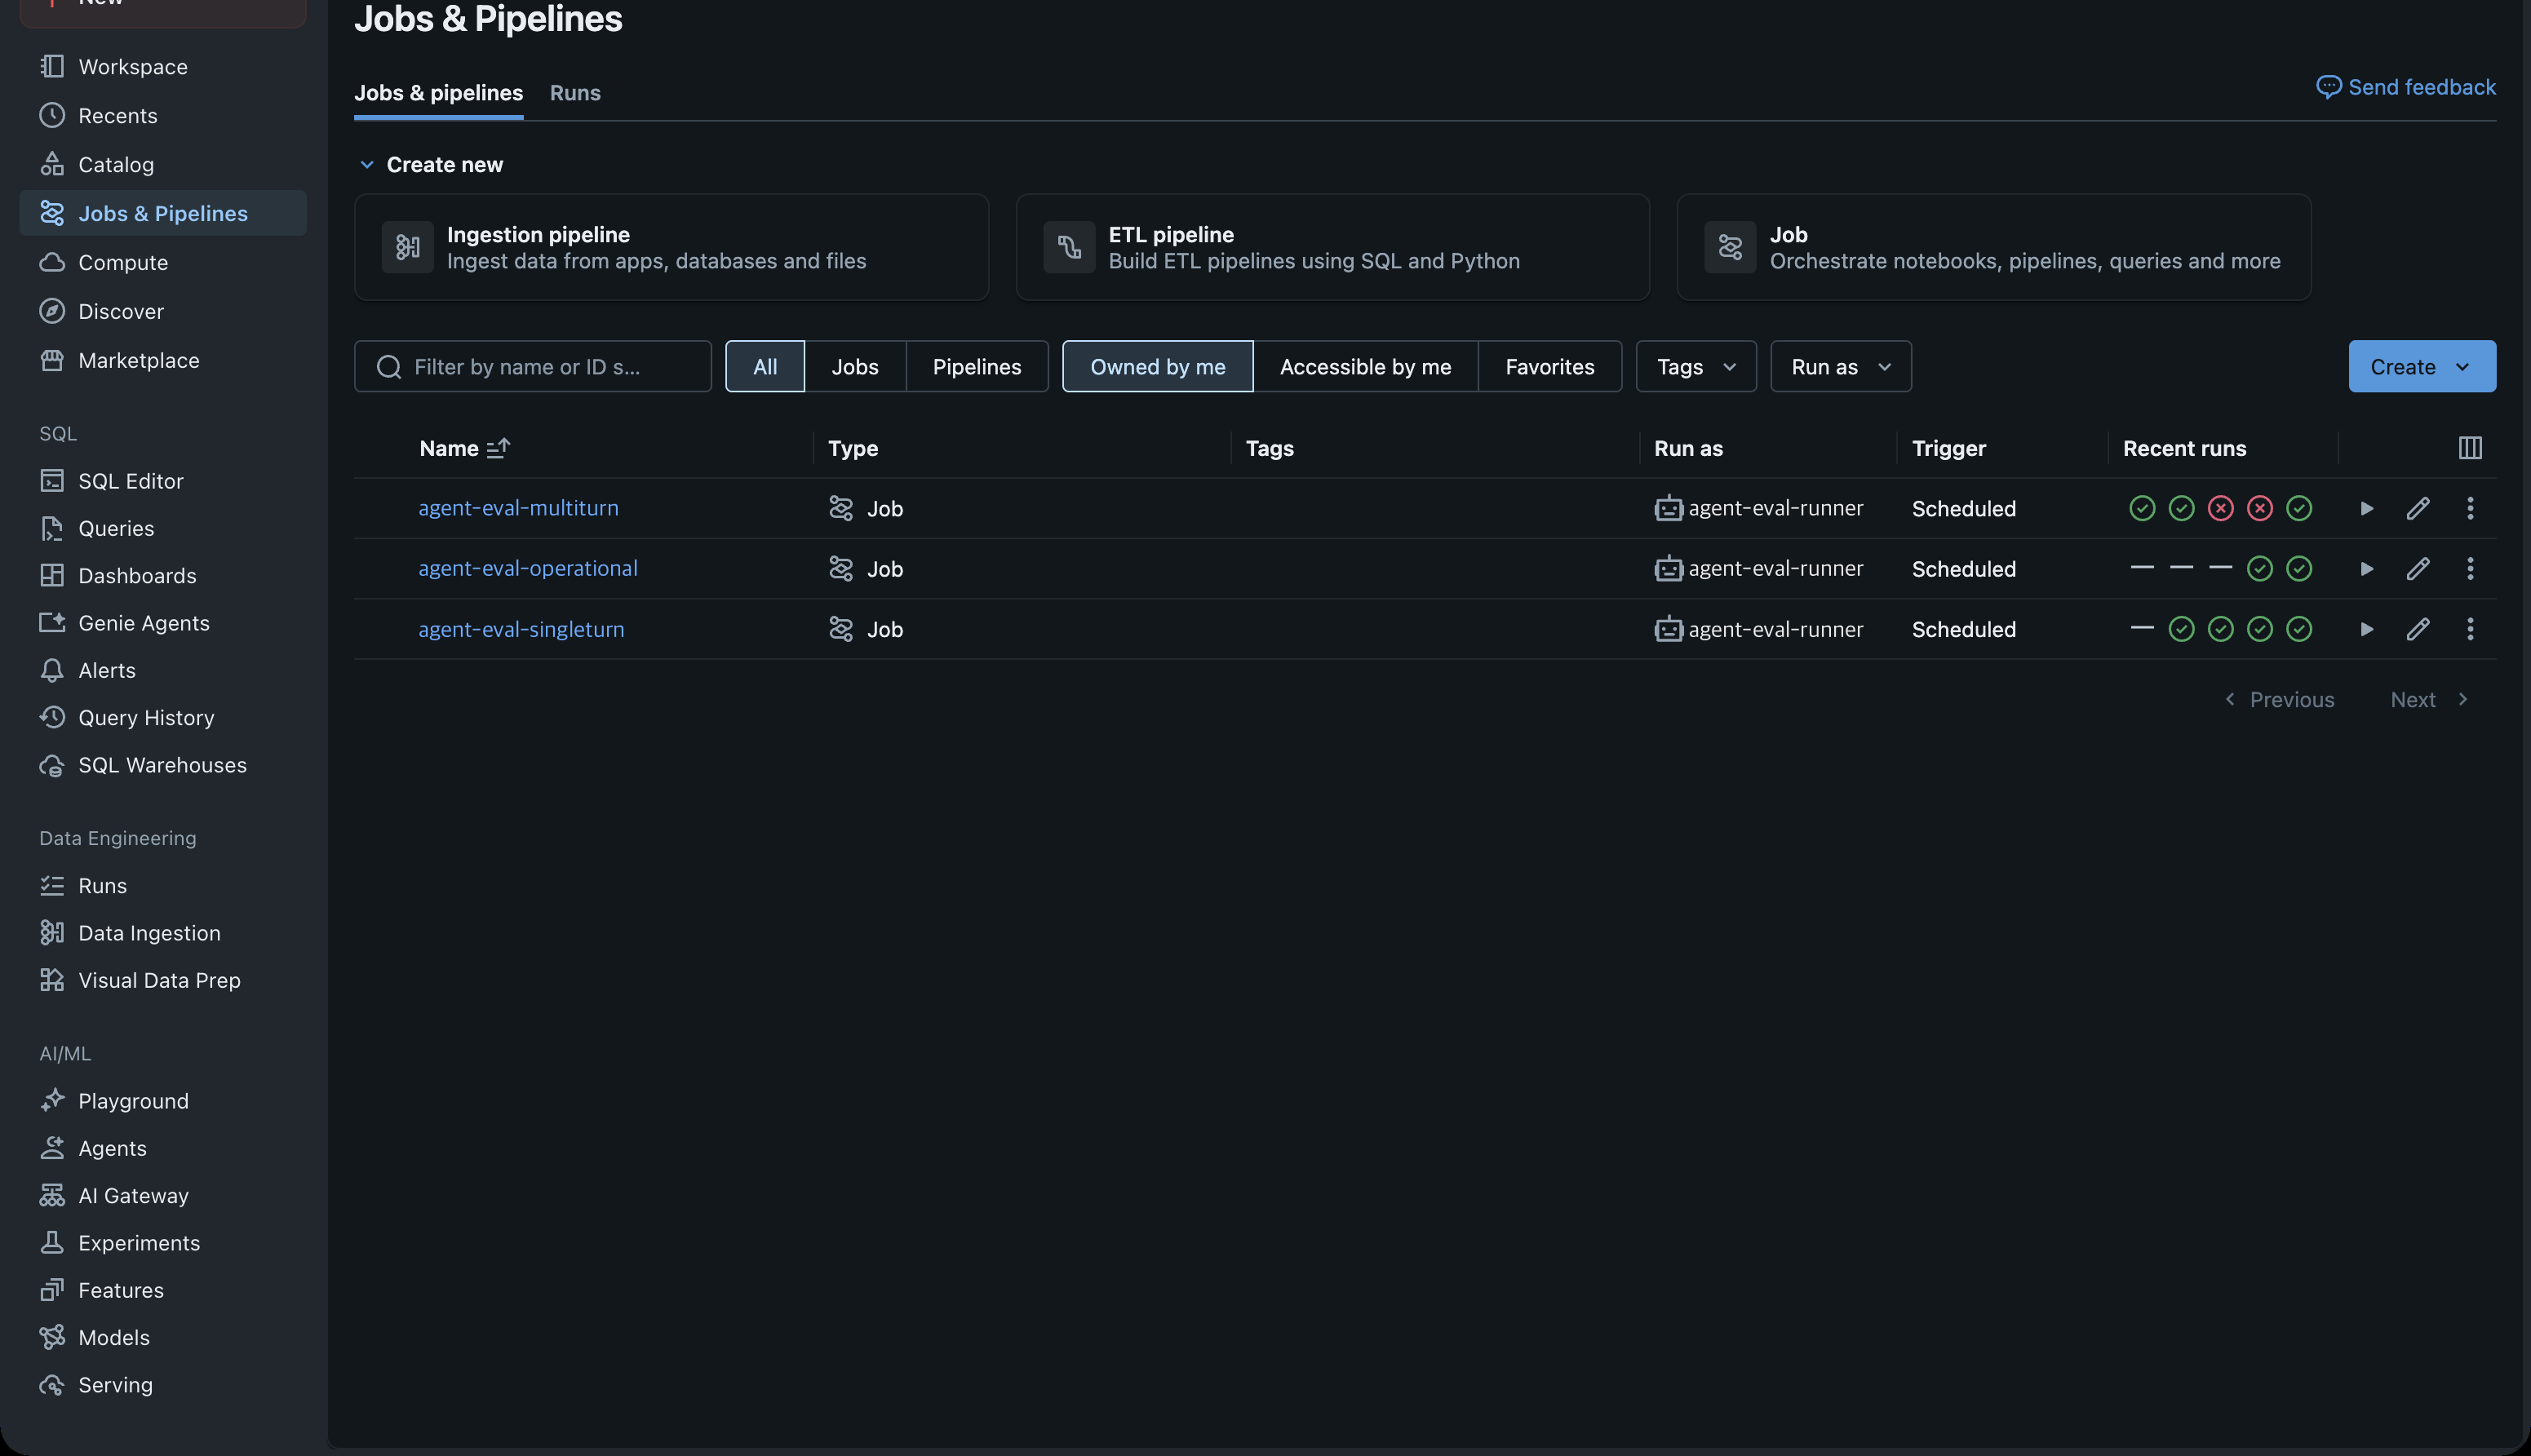
배포하면 Jobs & Pipelines 에 세 Job 이 나옵니다. Run as 칸이 runner SP, Trigger 칸이 Scheduled 인지 확인합니다.
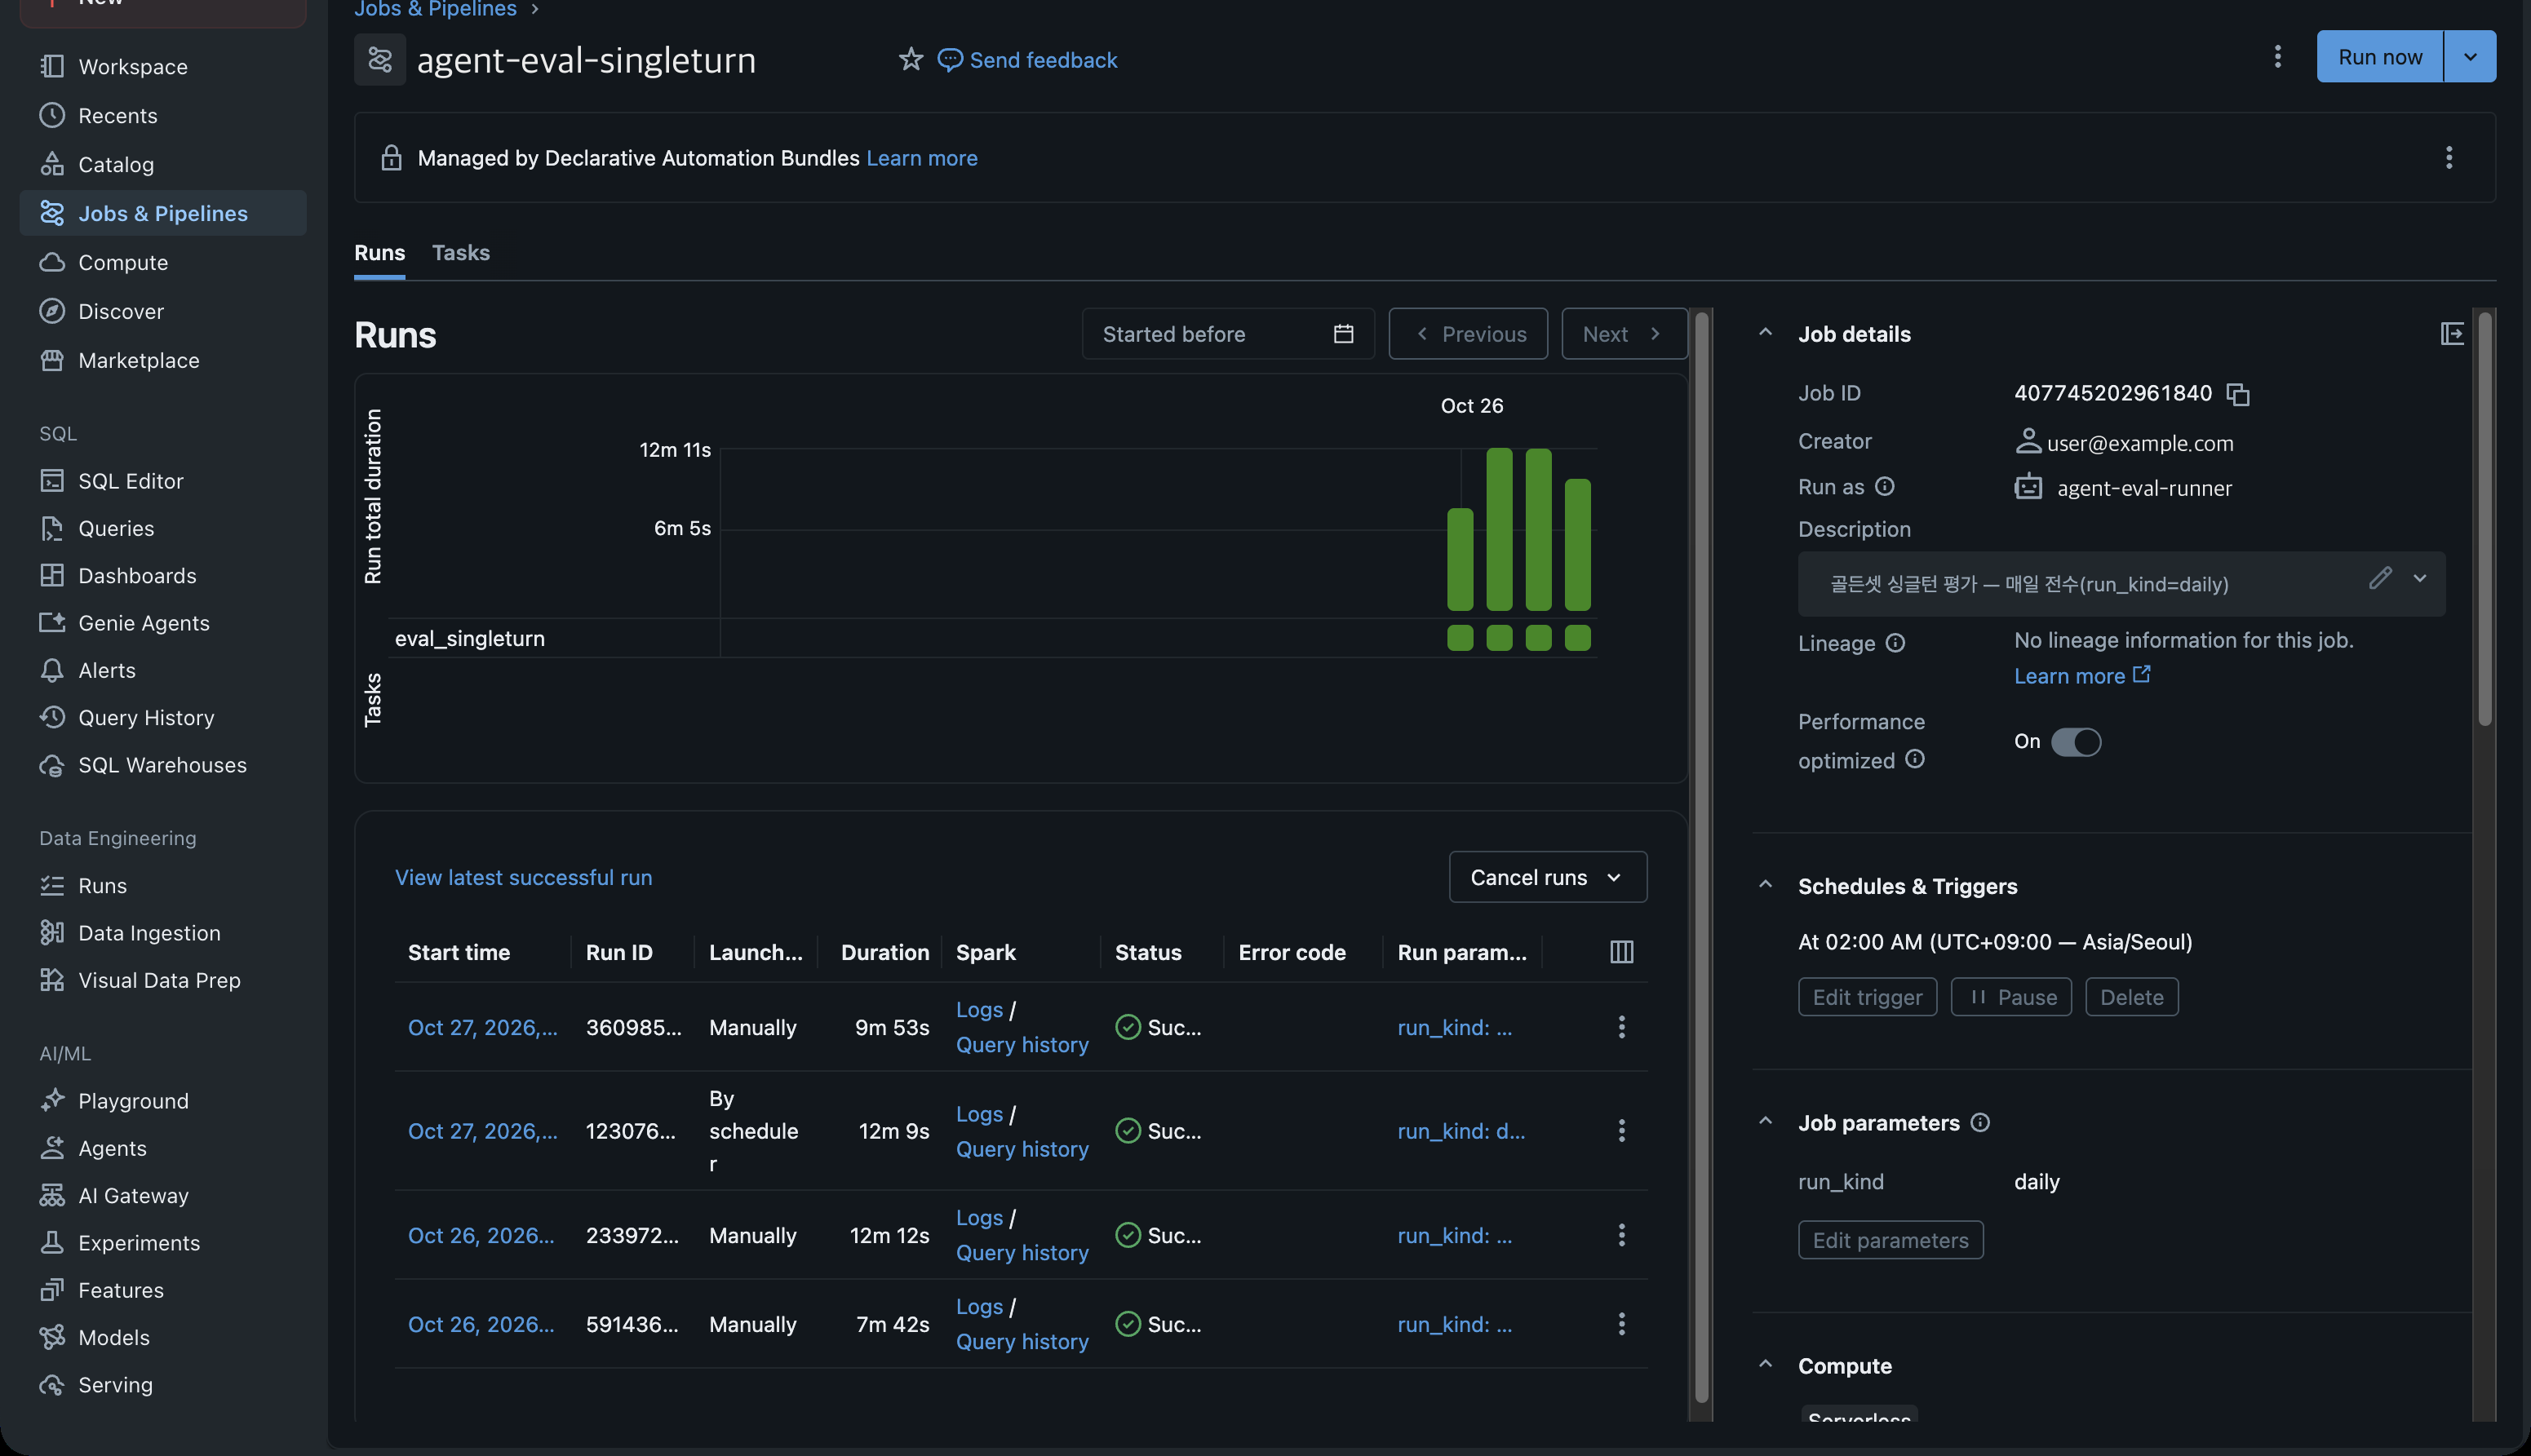
Job 을 누르면 오른쪽 Schedules & Triggers 에 실행 시각과 시간대가, Job parameters 에 run_kind 가 보입니다. 실행 목록의 Launched 칸에서 스케줄 실행(By schedule)과 수동 실행(Manually)을 구분합니다. "Managed by Declarative Automation Bundles" 는 bundle 로 배포한 Job 이라는 표시로, 화면에서 바꾼 정의는 다시 배포하면 databricks.yml 대로 돌아갑니다.
4. 사용자 피드백
4.1 피드백 형태
사용자 피드백은 답변마다 좋아요/싫어요 + 이유 문장(선택) 입니다. 이유는 사용자가 직접 쓰는 한 문장이고, 선택지나 코드로 나누지 않습니다. 화면에는 답변 아래 👍/👎 버튼을 두고, 싫어요를 누르면 이유 입력란을 띄우는 구성을 권합니다.
4.2 기록 방법
피드백은 답변의 trace 에 assessment 로 붙입니다. 그래야 콘솔에서 답변·도구 호출·심판 판정과 나란히 볼 수 있습니다.
import mlflow
from mlflow.entities import AssessmentSource


def log(trace_id: str, liked: bool, reason: str | None, user: str) -> None:
    """좋아요/싫어요와 이유 문장(선택)을 답변 trace 에 남긴다."""
    mlflow.log_feedback(
        trace_id=trace_id, name="user_feedback", value=liked,
        source=AssessmentSource(source_type="HUMAN", source_id=user),
        rationale=(reason or "").strip() or None,
    )
전제 — 앱이 피드백을 보낼 때 어느 trace 인지 알아야 합니다. 에이전트 응답에 trace id 를 실어 주거나, 피드백 API 가 conversation_id·턴 번호로 trace 를 찾아야 합니다. 응답 형식을 바꾸는 일이라 앱 쪽과 먼저 맞춥니다.
4.3 콘솔에서 확인
trace 별로 보기 — 답변 trace 의 Assess 패널에 user_feedback 이 사람 아이콘과 함께 심판 판정 옆에 표시되고, 펼치면 사용자가 쓴 이유가 보입니다.
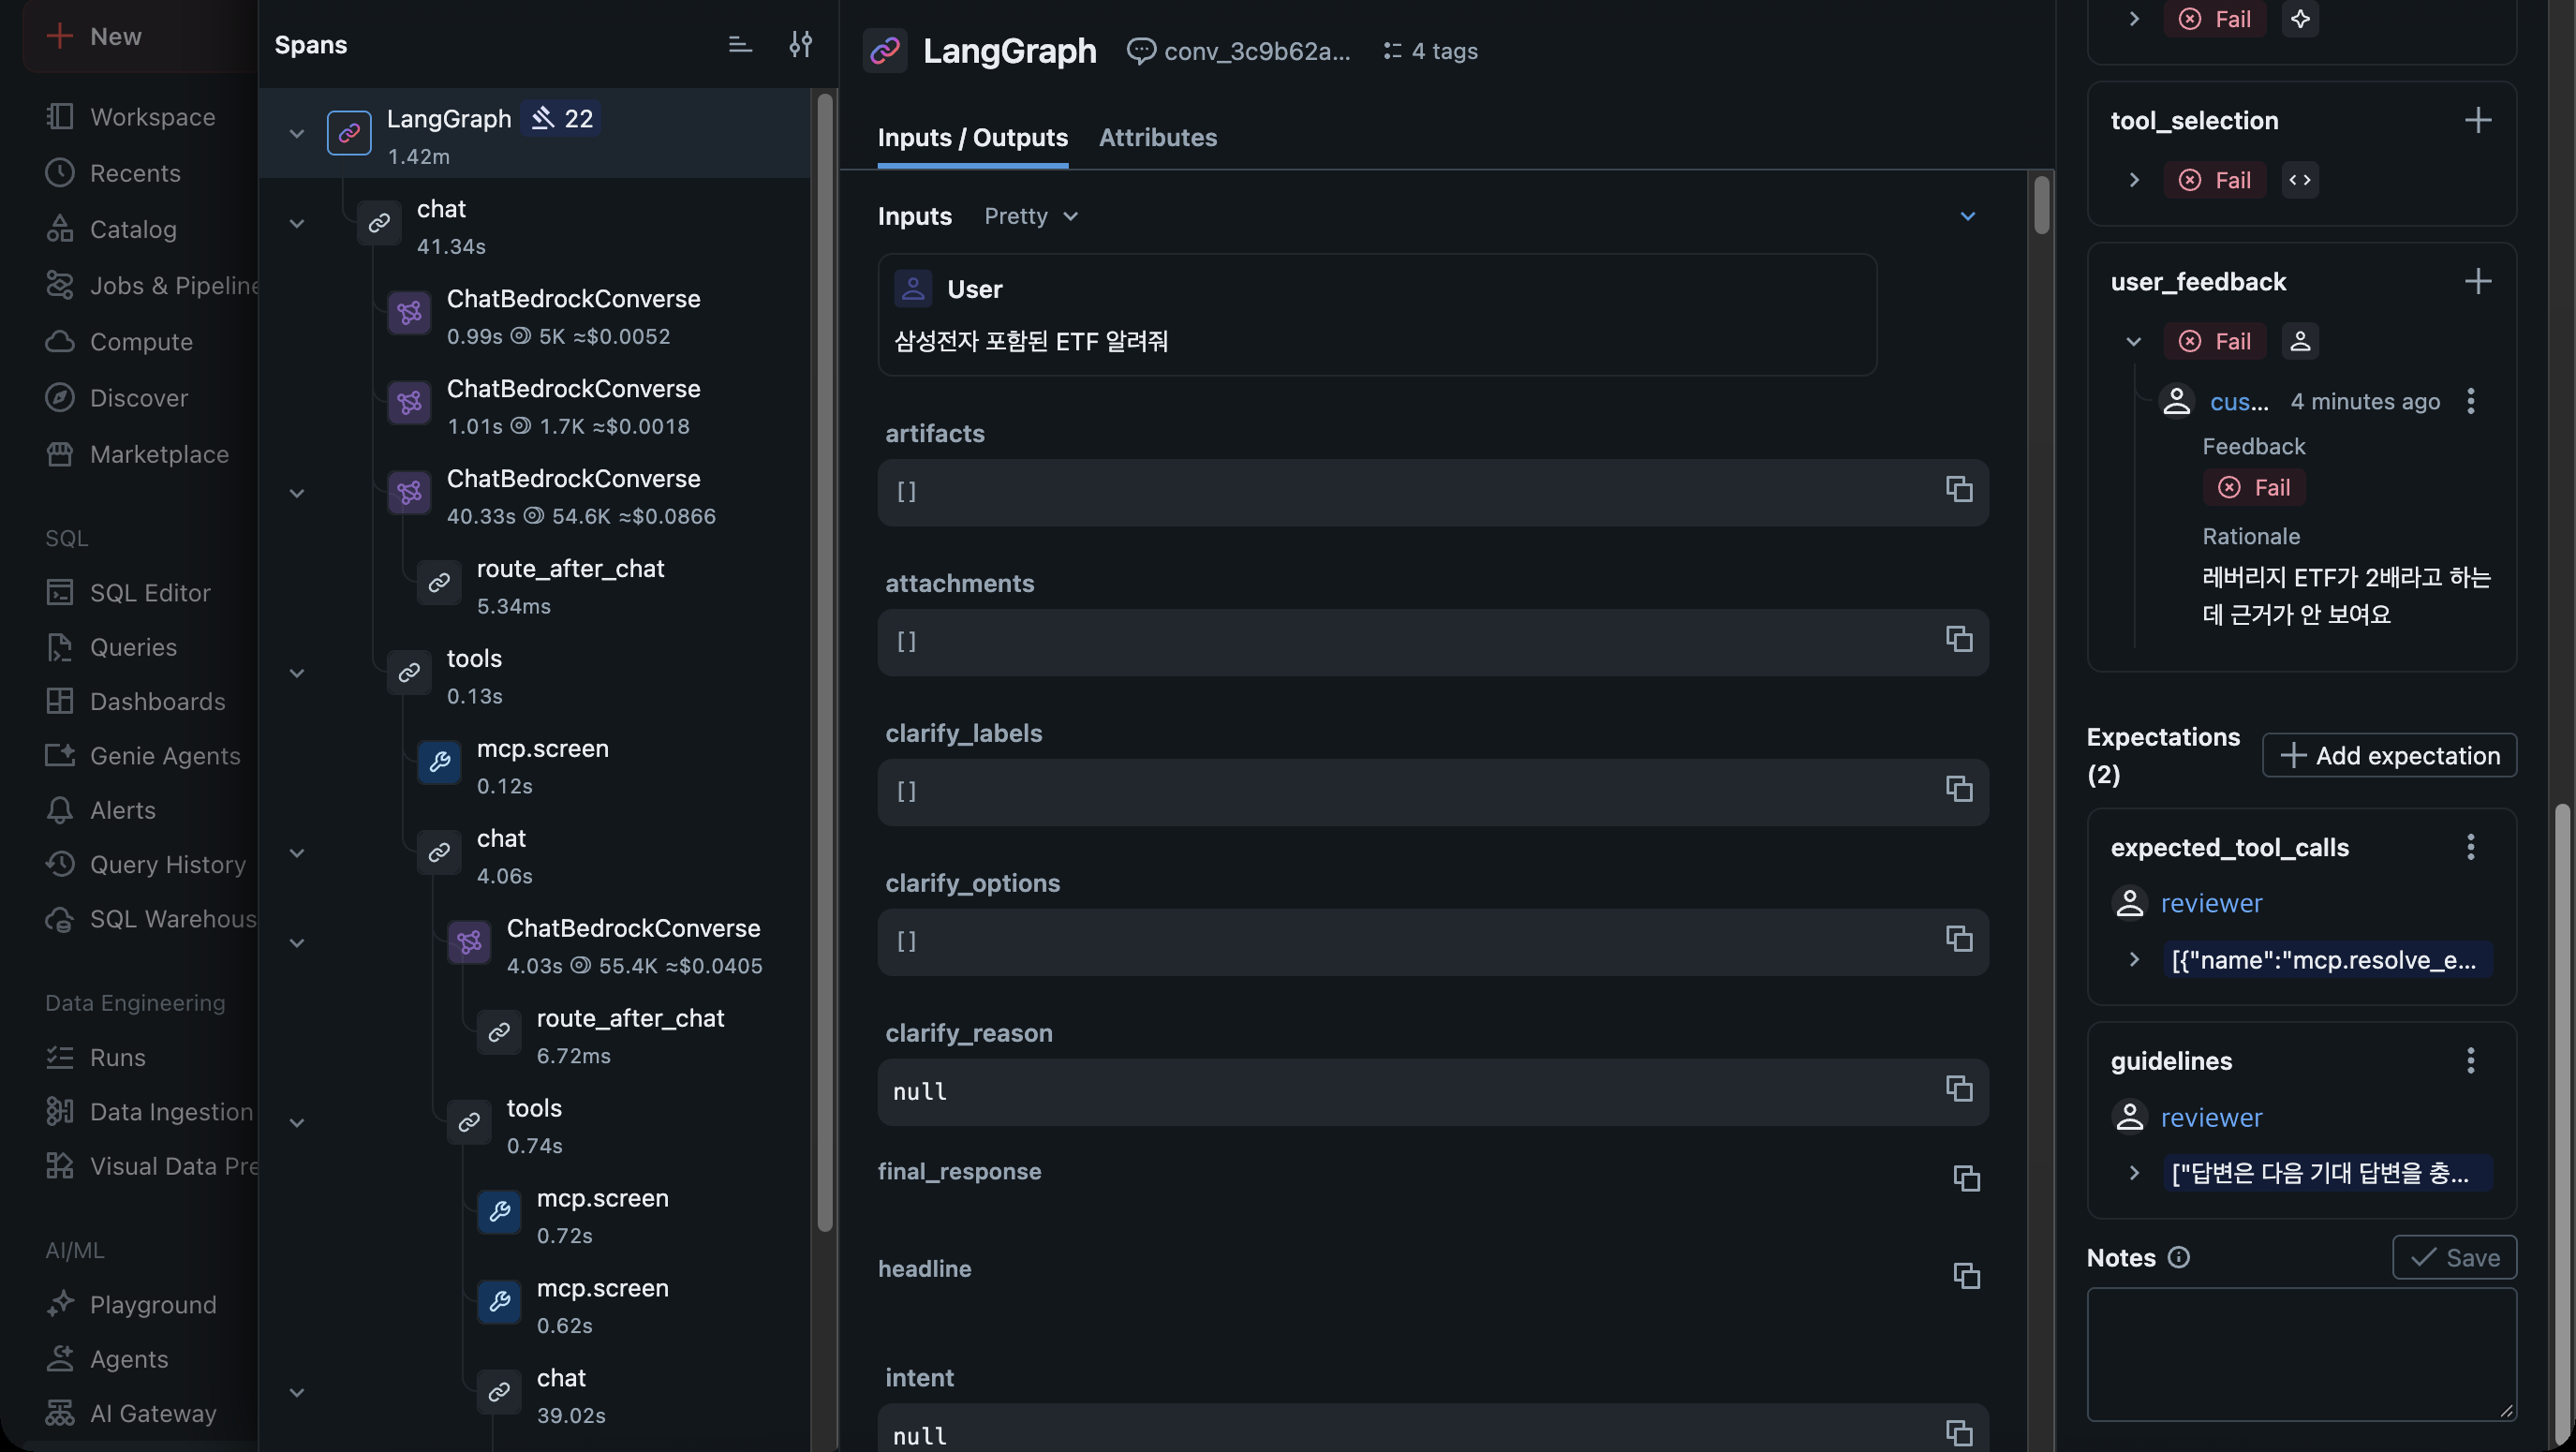
이 답변은 심판도 numeric_grounding 을 실패로 판정했습니다. 사용자가 지적한 내용과 심판 근거가 같습니다.
질문별로 모아 보기 — 평가 run 표에 user_feedback 칸이 생기고, 머리글에 좋아요 비율이 집계됩니다.
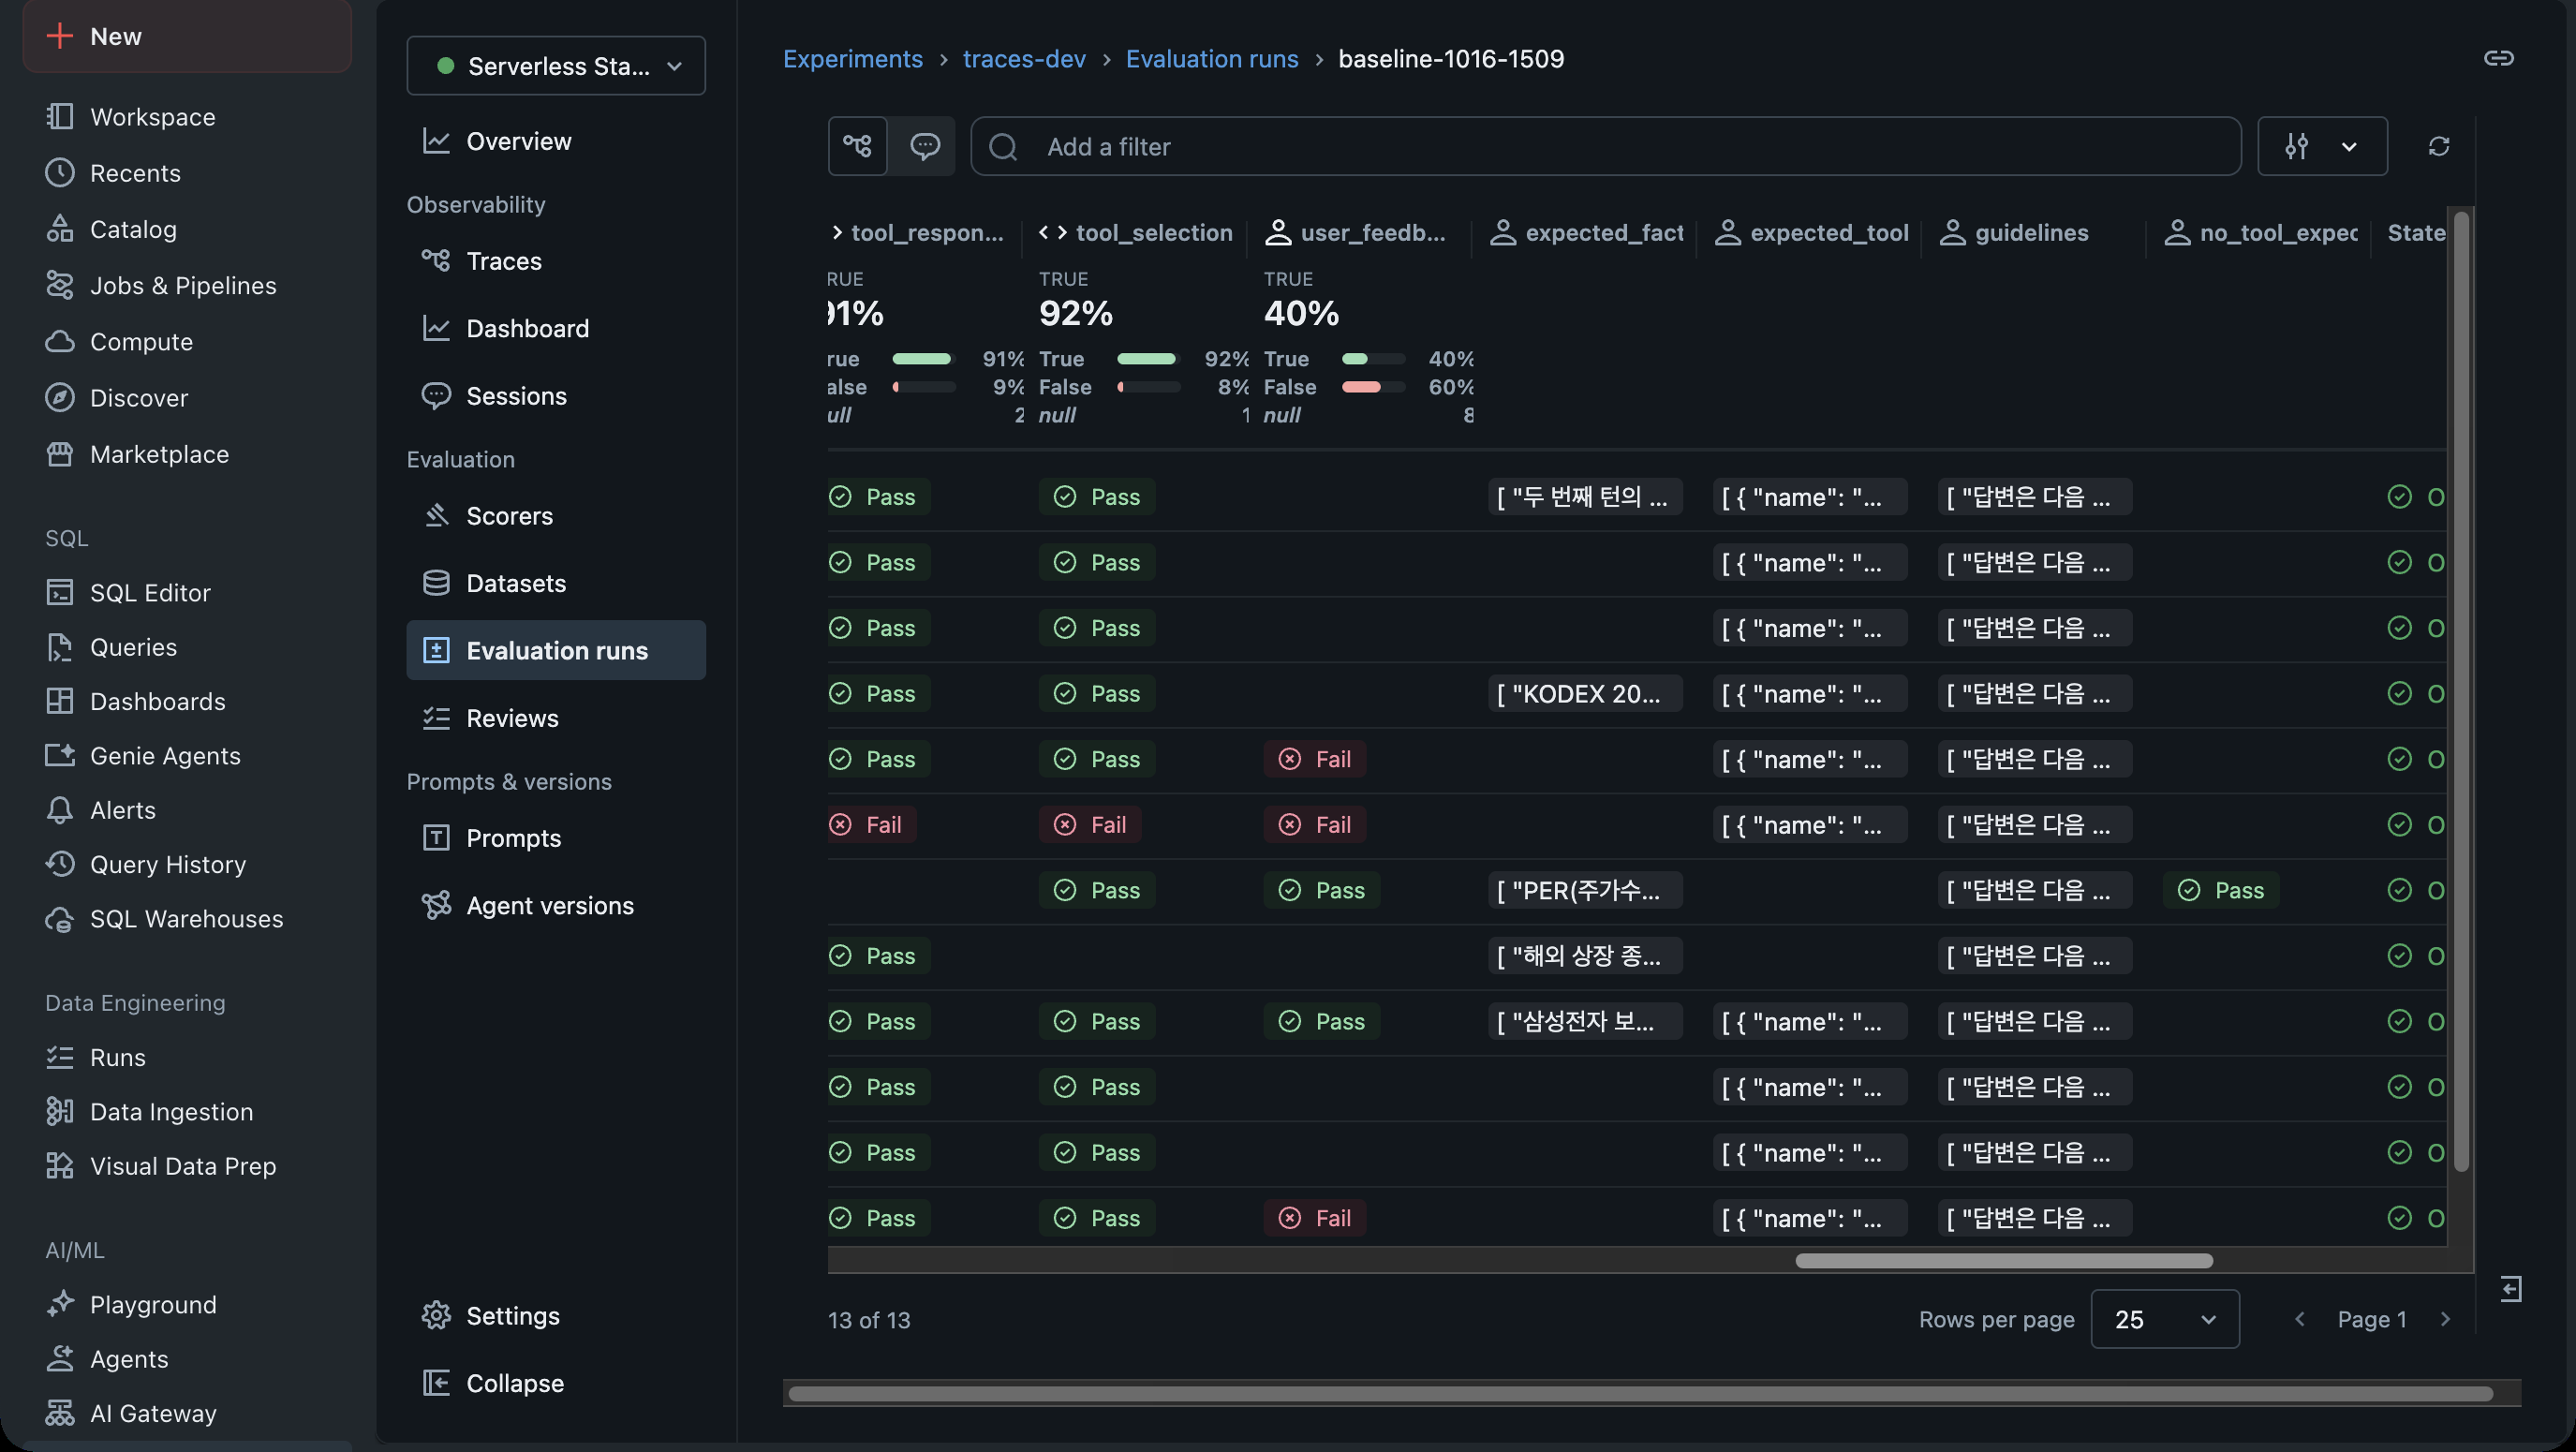
싫어요 행 가운데에는 도구 Scorer 도 함께 실패한 행이 있습니다. 화면의 tool_selection 칸은 현재 평가 코드에 없는 이전 버전 Scorer 입니다.
건수와 싫어요 목록 — 운영 Job 의 feedback_report task 가 전날 하루를 집계합니다.
$ python src/feedback.py report --warehouse <warehouse id> --experiment <에이전트 experiment>
2026-10-26(KST) 답변의 피드백
피드백 9건 · 좋아요 4 · 싫어요 5

싫어요 목록 — 담당 지정·골든셋 후보 검토용(trace id · 질문 · 이유)
- tr-… · 레버리지 ETF 수익률 알려줘 · 레버리지 ETF가 2배라고 하는데 근거가 안 보여요
- tr-… · …
위 화면과 집계는 평가 trace 에 시연용 피드백을 남겨 확인한 결과입니다.
4.4 활용 — 피드백에서 골든셋으로
- 싫어요 목록 검토 → 담당 지정: 매일 싫어요 이유를 읽고 아래 기준으로 담당을 정합니다. 같은 종류의 이유가 2주 연속 늘면 해당 지표를 다음 회차의 우선 개선 대상으로 둡니다.
- 싫어요 ↔ 심판 판정 대조 → 심판 보정: 싫어요인데 심판이 모두 통과시킨 답변은 심판이 놓친 결함입니다. 그 사례를 심판 지시문에 반영하고, 반대로 좋아요인데 심판이 실패시킨 답변은 오판 후보로 검토합니다.
- 싫어요 질문 → 검토 → 골든셋: 싫어요 질문을 자동으로 골든셋에 넣지 않습니다. 현업이 검토해 평가할 가치가 있는 질문만 골든셋 테이블에 다음 버전(
version = 2) 행으로 추가하고, 다음 회차부터 평가 문항이 됩니다. - 좋아요 비율 추이 → 운영 지표: 배포 전후 좋아요 비율을 같은 기간 길이로 비교해, 골든셋 평가와 실제 체감이 같은 방향인지 확인합니다.
| 이유의 내용 | 함께 볼 지표 | 담당 |
|---|---|---|
| 수치가 틀리거나 근거가 없음 | numeric_grounding · Correctness |
에이전트·데이터 |
| 질문과 다른 답 | RelevanceToQuery |
에이전트 |
| 원하는 정보가 빠짐 | expected_tools_called · tool_response_ok · ExpectationsGuidelines |
에이전트·MCP |
| 어렵거나 김 | 답변 형식 | 에이전트 |
| 부적절한 표현 | compliance |
에이전트·가드레일 |
| 그 밖 · 이유 없음 | — | 검토 |
현업이 골든셋 테이블에 직접 쓰려면 워크스페이스·SQL 접근 권한과 테이블 MODIFY 권한이, 콘솔에서 trace 를 열어 보려면 experiment CAN_READ 이상이 필요합니다(Label existing traces). 권한 부여가 어렵다면 싫어요 목록을 보여 주고 골든셋 행을 받아 넣는 전용 검토 화면을 두는 방법도 있습니다.
5. 정리
| 질문 | 답 |
|---|---|
| 운영 평가는 무엇을 보나요? | 실제 사용자 trace 를 정답 없이 채점해 골든셋 밖의 새 문제를 찾습니다 |
| 골든셋 trace 는 어떻게 빼나요? | 골든셋 평가가 붙인 출처 태그를 IS NULL 조건으로 걸러 냅니다 |
| 같은 trace 를 두 번 채점하지 않으려면? | 채점한 trace 에 채점 완료 태그(run id)를 붙이고 다음 실행에서 거릅니다 |
| 대시보드와 평가 run 은 어떻게 나눠 쓰나요? | 회차 결과는 run 값, 추이는 대시보드로 봅니다 |
| 매일 실행은 어떻게 하나요? | Lakeflow Job 3개를 bundle 로 배포하고, runner SP 로 실행하며, 심판은 UC 서비스 자격 증명으로 호출합니다 |
| 피드백은 어디로 가나요? | trace 에 user_feedback 으로 남고, 싫어요 질문은 현업 검토를 거쳐 골든셋 새 버전이 됩니다 |
세 편을 이으면 설계(지표·골든셋) → 배포 전후 골든셋 평가 → 운영 평가 → 피드백 → 골든셋 새 버전의 순환이 됩니다. 처음에는 정답 없이 판정하는 지표로 시작하고, 골든셋이 검토를 거쳐 단단해질수록 정답에 의존하는 지표의 비중을 늘려 가면 됩니다.
참고
'Databricks > MLflow' 카테고리의 다른 글
| 에이전트 품질 ② 골든셋 평가 — MLflow Evaluation 기반 싱글턴·멀티턴 채점 (0) | 2026.10.28 |
|---|---|
| 에이전트 품질 ① 설계 — 단계별 평가 지표와 골든셋 작성법 (0) | 2026.10.28 |
| 프롬프트를 컴포넌트로 나눠 조립하기 — 버전 관리는 MLflow Prompt Registry (0) | 2026.08.30 |
| Databricks LLMOps ③ MLflow Tracing — LangGraph 관측·한국어 PII 마스킹 (0) | 2026.07.06 |
| Databricks LLMOps ② Prompt Registry — UC 기반 프롬프트 버전·alias 관리 (0) | 2026.07.06 |


댓글